
Близько 90% власного коду Claude Code вже передано Claude для написання.
Оскільки тепер код пише ШІ, кількість змін відповідно різко зросла: з червня по вересень кількість PR, злитих у кодову базу, зросла більш ніж удвічі.
У всій Anthropic кількість змін, злитих у основну кодову базу щодня, зросла з приблизно 2500 у травні до понад 30000 у вересні.
За такого обсягу коду, чи встигають люди його читати? І якщо навіть рев'ю передано ШІ, хто визначає, чи припустився він помилки?
15 жовтня команда Claude Code публічно розкрила свій внутрішній процес рев'ю коду, показавши, що хоча кількість PR подвоїлася, частка PR, які потребують відкату, насправді впала більш ніж на 40% відносно цього.
Вони досягли цього завдяки шести рівням перевірок плюс механізму резервного відкату для швидкого виявлення та швидкого відкату.
Судження команди Claude Code таке:
За такого масштабу порядкове рев'ю людьми вже не є реалістичним.
Але вони не скасували рев'ю; натомість передали більшість роботи з читання коду машинам.
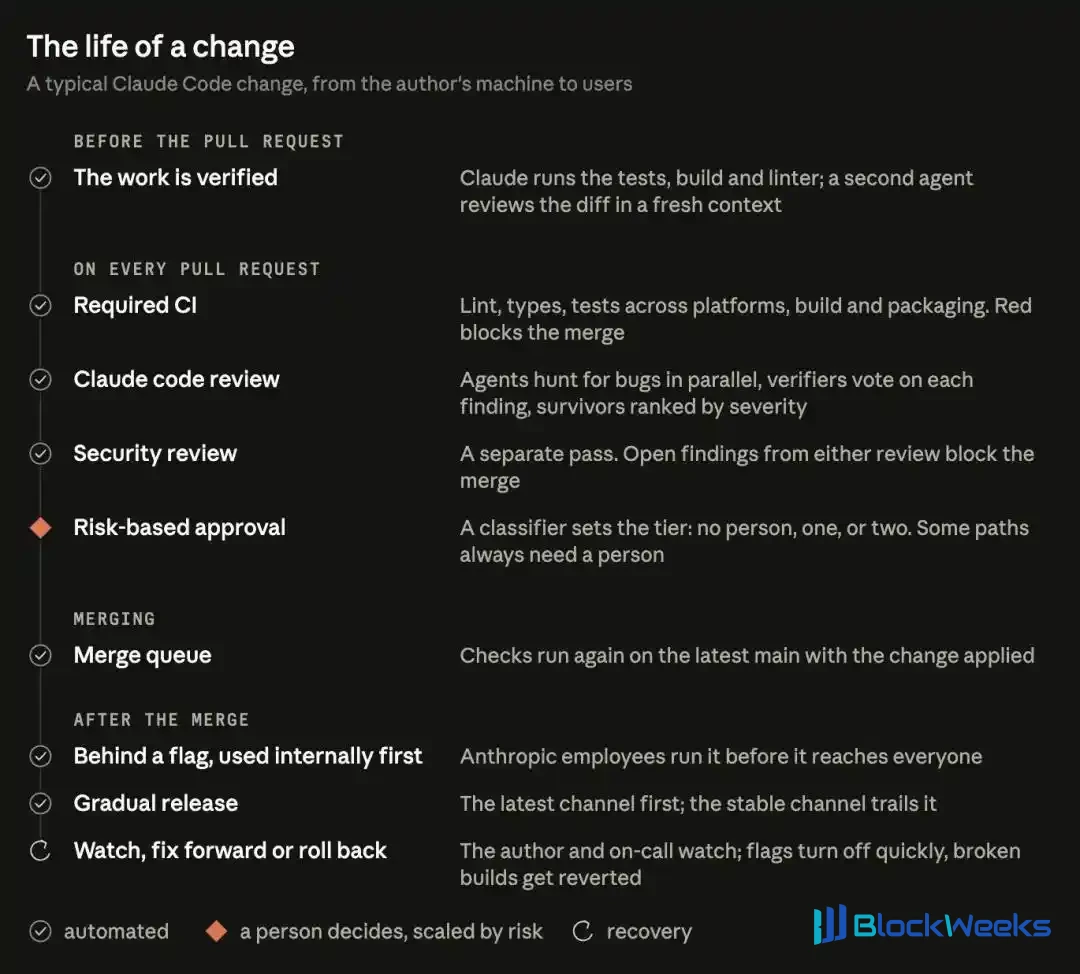
Перш ніж фрагмент коду, написаного ШІ, потрапить у продакшн, він має спершу пройти тести, пройти рев'ю ШІ та безпеки, а потім, залежно від ризику, ухвалюється рішення, чи потрібне схвалення людини.
На думку команди Claude Code, питання "чи хтось читав цей код" не є достатньо точним.
Справжнє питання має бути таким:
Що може піти не так із цією зміною, і якщо щось піде не так, яка перевірка має це зупинити?
Перед рев'ю людини , ШІ спершу надає результати перевірки
Одна зміна має пройти шість перевірок, із запобіжною сіткою в кінці.
Перший бар'єр виникає перед створенням запиту на злиття (PR).
Claude має запустити тести та завершити збірку; для змін, що стосуються інтерфейсу, він також має зробити скриншоти для порівняння з дизайн-макетами.
Далі запускається субагент із свіжим контекстом для рев'ю діфу коду; він не брав участі в написанні коду й присвячений пошуку недоліків.
Офіційна вимога дуже чітка:
Claude має надати виконані команди та їхній вивід; просто відповісти "усі тести пройдено" не зараховується.
Звичайні розробники можуть наслідувати цей підхід: даючи ШІ завдання, чітко вказуйте, як саме перевірятиметься приймання.
Другий бар'єр — це рев'ю ШІ на PR.
Кілька агентів паралельно шукають помилки, а інша група голосуванням перевіряє. Лише коли досягнуто достатньої кількості голосів, проблему буде опубліковано в PR.
Коментарі, що стосуються лише стилю коду, діагностичних підказок або очищення коду, не публікуються в PR і відфільтровуються безпосередньо.
Коли ця система рецензування вперше запустилася в березні, частка внутрішніх PR, які отримували змістовні коментарі рецензентів, зросла з 16% до 54%.
Третій бар'єр — це перевірка безпеки.
Усередині команди, доки зауваження, залишені рецензуванням коду або перевіркою безпеки, не вирішені, PR не може бути злитий: або виправте їх, або закрийте їх із письмовим обґрунтуванням.
Четвертий бар'єр — це перевірки безперервної інтеграції (CI), включно зі стандартами коду, перевіркою типів, тестами платформи та збиранням пакетів.
Одна звичайна зміна інструменту командного рядка (CLI) може вимагати виконання десятків перевірок, перш ніж її передадуть на людське рецензування.
Повторювані проблеми також повинні ставати основою для наступного раунду перевірок.
CLAUDE.md фіксує домовленості проєкту, а REVIEW.md підказує рецензенту, на що звертати увагу і що можна пропустити, щоб проблеми, знайдені цього разу, ставали досвідом для наступного рецензування.
Коли той самий коментар згадується втретє, його слід записати в правила.
П'ятий бар'єр — це людське схвалення, яке є найкритичнішим; ми детально обговоримо його в наступному розділі.
Шостий бар'єр — це злиття та випуск.
Після того як зміна проходить попередні бар'єри, вона все ще має потрапити в чергу злиття і дочекатися своєї черги.
Коли настає її черга, система розміщує її на останній версії головної гілки, і всі перевірки запускаються знову.
Цей крок запобігає ситуації «кожна частина окремо в порядку, але при поєднанні виникають проблеми».
Після злиття нові функції також не одразу надсилаються всім користувачам.
Спочатку вони приховані за прапорцями функцій і відкриті лише для внутрішніх співробітників Anthropic. Співробітники інтенсивно використовують їх щодня і часто стикаються з проблемами раніше, ніж зовнішні користувачі.
А прапорець функції схожий на головний вимикач: без зміни коду чи повторного випуску версії він може вирішувати, чи ввімкнена функція, чи вимкнена.
Нарешті, є запасний варіант.
Якщо виникає проблема, спершу смикніть головний вимикач.
Команда чергує чергування щотижня, і кожен розбір інциденту після його завершення повинен запитувати: на якому бар'єрі це мало бути зупинено?
Отже, рецензування не зникло — воно стало шарами перевірок, що проходять через розробку, злиття та випуск.
Де межі схвалення без участі людини
Після того як перші чотири бар'єри всі зелені, п'ятий бар'єр вирішує на основі розподілу за рівнем ризику, скільки людей повинні схвалити цю зміну.
Документація, тексти, функції, видимі лише всередині, і нові зміни, приховані за прапорцями, є низькоризиковими; щойно автоматичне рецензування та перевірки безпеки пройдені, вони можуть пропустити людське схвалення.
Звичайні продуктові зміни, а також чутливі області, як-от кешування, автоматичний оновлювач і системні підказки, потребують однієї людини.
Код із найвищим ризиком, а також кілька визначених шляхів потребують двох людей.
На перший погляд, низькоризикові зміни вже «без водія»?
Не все так просто.
Рівень ризику визначається самою зміною: перший класифікатор читає код і встановлює ризик, а другий потім вирішує, чи потрібне додаткове людське схвалення.
Чутливі шляхи, позначені власниками коду, а також усі файли робочих процесів CI повинні бути переглянуті людиною.
Полегшений канал схвалення також має поріг: він відкритий лише для людей зі списку «довірених авторів» репозиторію; будь-хто поза списком повинен знайти іншу людину для схвалення.
Людина, яка керує написанням коду ШІ, сама вважається рецензентом і повинна нести відповідальність за зміну так само, якби вона написала код вручну.
Схвалення без участі людини не означає відсутність відповідальності.
Люди повинні вирішувати, чи слід створювати функцію, чи розумна архітектура і чи можуть наявні перевірки покрити ризик цієї зміни.
Отже, у команди Claude Code є правило: код, який ви зливаєте — якщо щось піде не так, зазвичай ви це виправляєте.
Перш ніж натиснути «схвалити», рецензент повинен уміти чітко пояснити: що саме перевірили ці перевірки і які ризики залишилися непокритими.
Якщо ви не можете це пояснити, не поспішайте натискати «схвалити» — спершу додайте необхідну перевірку.
AI-рев'ю теж може зазнавати невдачі
Автоматизоване рев'ю також може застрягти.
PR для проєкту CLI за ніч пройшов понад п'ятдесят раундів рев'ю та виправлень, доки автор зрештою не зупинив це вручну.
Людина може за секунду проігнорувати дрібну проблему, а AI — ні: він сумлінно піде її виправляти, а після виправлення з'явиться ще один коміт і ще один раунд рев'ю.
Команда використала git blame, щоб простежити історію, і виявила, що з проблем, які рецензент раз за разом позначав, близько 59% були старим кодом, який існував ще до першого раунду рев'ю. Він рідко знаходив нові баги; кожного раунду він лише викопував ще кілька старих.
Згодом вони змінили чотири правила:
Якщо після трьох раундів усе ще не пройдено, нагадайте автору відступити й переосмислити підхід;
Після перших кількох раундів перевіряти лише щойно додані зміни;
Вказувати на проблеми одного типу всі одразу;
Не повторювати проблеми, які вже були підняті.
Ефект був негайним.
Частка внутрішніх PR, які проходили після одного раунду рев'ю та виправлень, зросла з 65% до 78%; ті, що потребували п'яти або більше раундів, впали з 8,9% до 1,5%; середня кількість рев'ю знизилася з 2,08 до 1,32.

Після коригування правил повторного рев'ю частка проходження після одного раунду рев'ю та виправлень зросла з 65% до 78%, а середня кількість рев'ю знизилася з 2,08 до 1,32.
Мистецтво рев'ю наполовину полягає в тому, щоб знаходити проблеми, а наполовину — в тому, щоб знати, коли зупинитися.
Чи означає багаторівневе рев'ю, що воно безпомилкове?
Сама Anthropic навела контрприклад.
26 березня Claude Code випустив оптимізацію: коли сесія простоює понад годину, один раз очищати старі записи міркувань.
Але через баг це очищення запускалося на кожному кроці після відновлення розмови. У результаті Claude став забудькуватим, почав повторюватися й аномально використовувати інструменти. Баг не виправляли до 10 квітня.

Після простою старі міркування мали очищатися лише один раз, але насправді вони очищалися на кожному кроці; червона рамка позначає помилково видалений вміст.
Офіційний постмортем 23 квітня визнав:
Ця зміна пройшла кілька раундів людського та автоматизованого рев'ю; юніт-тести, наскрізні тести й внутрішнє догфудинг не змогли її виявити, і лише підтвердження першопричини зайняло понад тиждень.
Переломний момент настав у постмортемі.
Команда повторно перевірила PR, що спричинив інцидент, за допомогою Code Review; коли було надано достатній контекст із відповідних репозиторіїв, Opus 4.7 знайшов баг, а Opus 4.6 — ні.
Цей бектест показав, що і можливості моделі, і повнота контексту впливають на результати виявлення. Тож вони зробили так, щоб рев'ю залучало більше репозиторіїв.
Сьогодні кожен інцидент стає екзаменаційним питанням.
Команда збирає PR, залучає інженерів, знайомих із кодом, щоб підтвердити помилки в них одну за одною, і компілює їх у тестовий набір.
Рев'юер щодня запускається проти цього тестового набору. Щоразу, коли коригуються промпти, інструменти чи моделі, він також використовується для перевірки ефекту: якщо оцінка не покращується, коригування не приймається.
Команда також не перебільшувала.
Після впровадження змін розробники та чергові фахівці все ще повинні виявляти аномалії за допомогою інформаційних панелей даних.
Механізм «запобіжника», який автоматично посилює схвалення на основі таких метрик, як частота відкатів, ще не створено. Інженери хочуть спершу додати цей запобіжний захід, перш ніж дозволити більшій кількості змін проходити без схвалення людиною.
Рев'ю неминуче щось пропустить; виявлення та виправлення також повинні встигати.
Один член команди Claude Code пояснив це так: уповільнення справді зменшує кількість помилок, але головним чином тому, що ви робите менше всього. Тому вони воліють витрачати зусилля на швидше знаходження проблем і швидше їх виправлення.
Коли одна людина пише код за допомогою ШІ, що потрібно прийняти
ШІ-рев'ю лише дає думки; ви все ще той, хто ухвалює рішення.
Тож не поспішайте прагнути до «не потрібно дивитися» — натомість спершу змусьте ШІ відповідати на три запитання з кожною поставкою.
По-перше, як це було перевірено?
Які перевірки були запущені, якими були результати та які випадки ще не охоплені.
Борис Черни, творець Claude Code, сказав, що надання Claude способу перевіряти себе, можливо, є найважливішим. Він оцінює, що це може зробити якість кінцевого результату в 2–3 рази вищою за початкову.

Борис Черни рекомендує дозволити Claude перевіряти власну роботу, щоб сформувати цикл зворотного зв'язку; він оцінює, що якість кінцевого результату можна підвищити в 2–3 рази.
По-друге, на що це вплине?
Які користувачі, дані та дозволи задіяні у зміні.
Якщо ви доручаєте ШІ додати функцію спільного доступу до інструменту звітності, ви повинні чітко запитати: хто може відкрити посилання і що можна побачити після його відкриття.
По-третє, як відкотитися, якщо щось піде не так? Чи можна вимкнути нову функцію одним кліком і повернутися до попередньої версії.
Зробіть архівну фіксацію перед початком і тримайте кожну зміну якомога меншою. Спершу мати можливість відкотитися, потім говорити про менше рев'ю.
Окрім цих трьох запитань, розвиньте ще три звички.
По-перше, переглядайте з іншим «мозком».
У сесії, де пишеться код, найлегше заплющити очі на власні помилки.
Відкрийте нову сесію або доручіть субагенту переглянути з абсолютно новим контекстом; локальні команди /code-review та /security-review також можна запускати безпосередньо.
По-друге, класифікуйте зміни за рівнями.
Для змін тексту та коригувань стилю зливайте після проходження перевірок і підтвердження фактичного ефекту; для всього, що стосується входу в систему, платежів або видалення даних, людина повинна ретельно перевірити ключову логіку та додати цільові тести.
Спочатку будьте суворішими, а коли процеси перевірки та відкату працюватимуть гладко, поступово зменшуйте ручне рев'ю низькоризикових змін.
По-третє, якщо три раунди не дали результату, змініть підхід.
Якщо ШІ вніс правки протягом трьох раундів і все ще ходить по колу, не штовхайте його до четвертого раунду — спершу запитайте, чи не є сам підхід неправильним.
Найважливіше: те, що ШІ каже «пройдено», не означає, що ви завершили приймання.
Ви доручили йому написати код, і ви також повинні відповідати за результати після його впровадження.
Мета команди Claude Code — зробити так, щоб більшість PR залучали щонайбільше одну особу, водночас стримуючи частку відкатів і частку інцидентів.
Людську увагу слід більше зосереджувати на оцінці ризиків, підтвердженні того, чи достатньо перевірок, і на тому, як виправити ситуацію після виникнення помилок.
Люди не повинні читати кожен рядок коду, але за кожен реліз хтось має нести відповідальність.
Джерела:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Редактор: Yuanyu
Ця стаття походить із публічного акаунта WeChat «Xinzhiyuan» (ID: AI_era), автор: ASI Revelation