Минуло лише два місяці з моменту випуску GPT-6 Astra, а GPT-6.2 Astra вже наближається на горизонті.
Однак індустрія втіленого інтелекту ще не оговталася від попереднього удару.
Усе сталося так раптово й застало людей зненацька.
Я досі пам'ятаю, що коли GPT-6 Astra тільки з'явився, група практиків у сфері втіленого ШІ була приголомшена. Зокрема, інженери, які працюють над попереднім навчанням на передовій, усі боялися за свої робочі місця.
Нещодавно в галузі поширилися новини про те, що деякі компанії у сфері втіленого інтелекту почали скорочувати алгоритмічні посади.
Можливості, які раніше вимагали великої кількості даних, обчислювальних ресурсів та інженерів-алгоритмістів, щоб
Diandian
виточувати їх, GPT-6 Astra може продемонструвати в деяких тестах без додаткового постнавчання для конкретних завдань.
Як людям ще змагатися???
Інженер, який працює над розробкою моделей у робототехнічній компанії, розповів Quantum位:
Порівняно з тим, що втілений інтелект ще не побачив нового прориву на рівні парадигми, загальні великі моделі, представлені Astra, вертикально вражають індустрію втіленого інтелекту через кодування. Ось це справжній шок.
Тиск, спричинений цим шоком, походить не повністю з Кремнієвої долини.
Порівняно з технологічним прогресом закордонних компаній, що розробляють великі моделі, таких як OpenAI, вітчизняні компанії у сфері втіленого інтелекту більш чутливі до наступних кроків місцевих гравців ринку великих моделей.
Kimi
,
DeepSeek
, Zhipu... Ці назви стають змінними, на які індустрія втіленого інтелекту змушена звертати увагу.
У нещодавно популярному оцінюванні RoboDojo дедалі більше команд також почали намагатися впроваджувати загальні великі моделі (наприклад, GPT-6 Astra) у власні робототехнічні системи, демонструючи потужне узагальнення та вражаючі можливості.
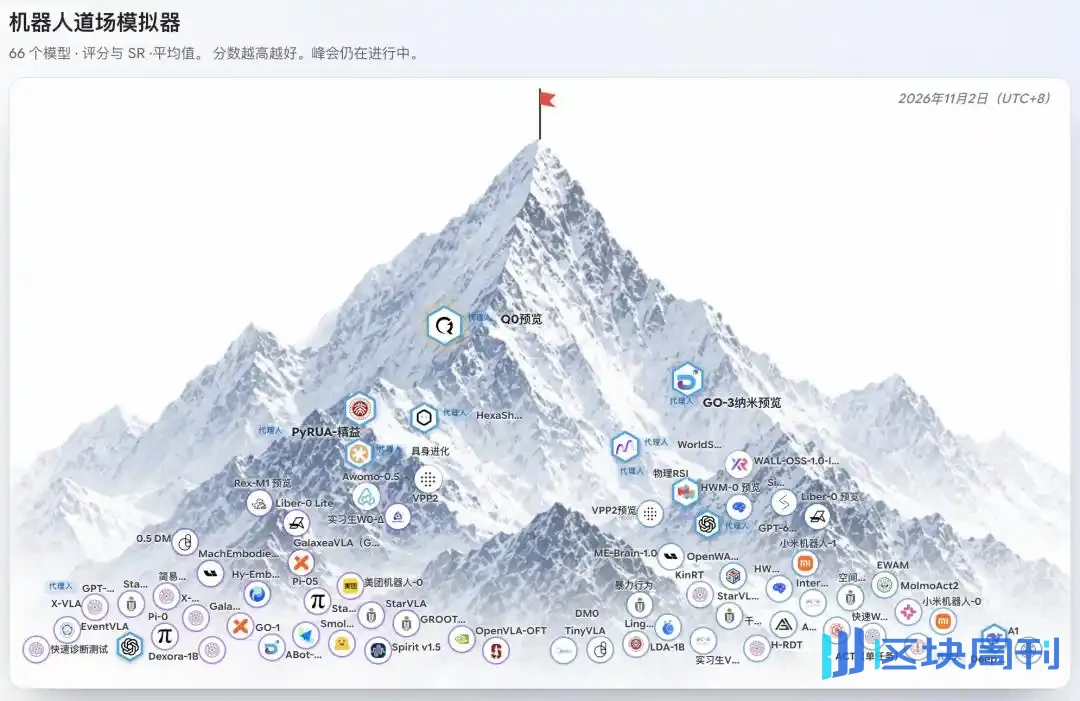
За словами Чень Тяньсіна, першого автора еталонного тесту RoboTwin/RoboDojo, деякі команди, які спочатку наполягали на навчанні власних фундаментальних моделей для втіленого інтелекту, тепер також починають подавати рішення, що поєднують такі технології, як Robot-Use-Agent (RUA), використовуючи загальні великі моделі для виконання робототехнічних завдань.
Ефект досить прямий. Моделі, які спочатку набирали лише 20 або 30 балів, після поєднання з рішеннями на основі Astra можуть підвищити свої оцінки до 50 або 60 балів.
Оцінки в таблиці лідерів зросли, але в головах компаній у сфері втіленого інтелекту лише одна думка:
Чи все ще потрібно розробляти моделі власними силами... (плаче)

Як аспірант напряму втіленого інтелекту в MMLab Гонконгського університету, Чень Тяньсін брав участь у написанні звіту RoboDojo з оцінювання та атестації GPT-6 Astra (далі — «звіт»).

△Ранній звіт з оцінювання команди RoboDojo про GPT-6 Astra
Згадуючи один день у середині вересня, Чень Тяньсін розповів Quantum位, що коли його партнери один за одним приносили результати тестів, він кілька секунд стояв приголомшений:
Ви можете бачити, що його вплив на 3D-реконструкцію, математику та різні інші галузі є безпрецедентним.
Моторошно, справді досить моторошно.
Усі були приголомшені GPT-6
«Власні втілені моделі все ще додають 0,1 та 0,2 бала до 80 балів, тоді як GPT-6 Astra вже стрибнув з 80 балів до 90 балів за один раз».
Це яскрава аналогія, яку Чень Тяньсін навів, оглядаючи це оцінювання.
Що ще вражає, так це те, що в деяких тестах Astra навіть не проходив додаткового посттренування для конкретних завдань і не використовував демонстрацій завдань; спираючись лише на мовні інструкції, він зміг виконати чимало завдань роботизованого маніпулювання.
Найбільше його здивувало те, що Astra раптом продемонстрував три здібності, які втілені моделі раніше мусили зосереджено долати.
Перша — це ICL (In-Context Learning).
Простіше кажучи, це дозволяє роботу швидко вивчити нове завдання за допомогою невеликої кількості контекстної інформації.
Наприклад, якщо людина записує відео, на якому виконує операцію, і додає текстові описи, робот може зрозуміти, як це робила людина, і спробувати відтворити це роботизованою рукою.
У липні цього року ICL все ще був досить популярним напрямом досліджень у спільноті втіленого ШІ. Поширена парадигма полягає в тому, щоб продемонструвати людські операції й змусити робота наслідувати їх для набуття нових навичок — так зване одноразове навчання в контексті.
Але спільнота виявила, що надання Astra зображувальних або текстових демонстрацій може дати вищий відсоток успіху, ніж без демонстрацій.
Ще більше здивувала його здатність до онлайн-адаптації. Дослідники навмисно змінили ракурс камери та систему координат дій, і Astra зміг скоригувати свою стратегію після кількох раундів спроб на основі фактичних результатів виконання, успішно завершивши завдання.
Іншими словами, він може не лише розуміти контекст, а й виправляти себе під час дії.
На думку Чень Тяньсіна, це тому, що загальні моделі самі по собі мають потужні здібності до розуміння контексту. Під час звичайної розмови вона може пам’ятати попередню історію розмови; отримавши відео, вона також може зрозуміти зв’язок між вмістом відео та текстом.
Перенесення цих здібностей на роботизоване маніпулювання означає, що проблема ICL, яка спочатку вимагала спеціальних досліджень, раптом отримала готове рішення.
Друга — це узагальнення та здатність до корекції OOD (Out-of-Distribution).
У реальних середовищах роботи легко потрапляють у ситуації, що виходять за межі їхніх тренувальних даних.
Наприклад, роботизована рука збирається схопити чашку, але чашку раптом штовхають, і її положення змінюється.
Модель, яка надмірно покладається на тренувальні дані, може все ще виконувати рух за початковою траєкторією і в результаті схопити порожнечу.
Однак Astra може коригувати свої дії на основі зміненої візуальної інформації та намагатися схопити об'єкт.
Це звучить як зовсім незначна дія, але за нею стоїть питання, чи може робот адаптуватися до реального світу.
Зрештою, у реальному світі ніхто не відповідає за те, щоб повертати кожну чашку на її позицію часів навчання.
Третє — це маніпуляція з відкритим словником.
Ця здатність передбачає узгодження між мовою та діями.
Наприклад, якщо користувач формулює запит на операцію різними способами, робот все одно може його зрозуміти та виконати.
У минулому часто існував розрив між розумінням мови та виконанням дій, і втіленим моделям було потрібне донавчання для конкретних завдань, щоб краще досягати узгодження.
Але Astra продемонструвала сильніші можливості в цьому відношенні. У деяких тестах навіть без додаткового донавчання та демонстрацій для конкретних завдань вона могла виконувати чимало завдань роботизованої маніпуляції, покладаючись лише на мовні інструкції.
На думку Чень Тяньсіна, три вищезазначені аспекти колись були надзвичайно важливими технічними тезами в галузі втіленого ШІ, і в минулому кожен із них міг бути представлений як окрема історія стартапу.
Тепер Astra вирішила всі три одразу, що є майже вибуховим шоком для початкового шляху досліджень і розробок втілених моделей.

△Результати тестування з нульовим навчанням на бенчмарку RoboDojo-Sim не означають, що Astra вже може стабільно виконувати ці завдання на реальних роботах.
У звіті команда RoboDojo зазначила, що тестування Astra на реальних машинах було тимчасово призупинено через проблеми безпеки.
Високі бали в таблиці лідерів симуляції поки що не можна безпосередньо прирівнювати до продуктивності в реальному світі.
Але цього вже достатньо, щоб змусити втілені компанії переглянути свої минулі інвестиції в дослідження та розробки.
Чому загальна велика модель, яка спочатку не створювалася для роботизованої маніпуляції, може швидко наблизитися до можливостей, які втілені компанії накопичували роками?
Це певною мірою ненавмисний успіх.
Хоча загальні великі моделі не починали вивчати робототехніку з нуля, вони увійшли в галузь робототехніки, несучи із собою низку здібностей, накопичених під час великомасштабного попереднього навчання, таких як мова, зір, міркування та кодування.
Ці здібності спочатку мали кожна своє призначення, але несподівано, коли їх застосовують до роботів, вони також можуть бути використані безпосередньо.
Натомість багато втілених компаній тренують роботизований мозок з нуля, і дані, які вони мають, переважно походять від самої роботизованої маніпуляції.

Щоб модель розуміла середовище, розуміла інструкції та вивчала дії, багато здібностей доводиться
Diandian
вибудовувати з обмежених даних.
Один входить у робототехніку з повним набором загальних здібностей, тоді як інший досі інвестує дані, обчислювальні ресурси та робочу силу окремо для кожної здібності.
У цьому змаганні самі стартові лінії різні.
Чи є ще потреба у власних моделях?
GPT-6 Astra справді дуже сильна, але вона ще не настільки сильна, щоб змусити втілені компанії просто скласти зброю та здатися.
Принаймні в реальному фізичному світі все ще залишається багато складних проблем, які чекають на своє вирішення.
Сюй Хуачже, засновник Pokebot, поділяє можливості втіленого інтелекту на три рівні: семантичне, просторове та фізичне узагальнення.
Він вважає, що Astra чудово справляється з першими двома, але все ще стикається з викликами у складному фізичному контакті, зміні зусиль, деформації об'єктів та високоточному маніпулюванні.
Наприклад, дати роботу знати, де знаходиться чашка і що їй слід простягнути руку, щоб її схопити, — це зовсім не те саме, що змусити його впевнено схопити чашку.
Чашка м'яка чи тверда? Яку силу слід застосовувати під час захоплення? Які зміни відбуваються після того, як об'єкт стиснули або зіткнулися з ним?
Ці проблеми неможливо вирішити, лише розуміючи візуальну інформацію та сприймаючи інструкції.

△Скріншот звіту
Команда RoboDojo також виявила під час свого оцінювання, що Astra не перевершує інші моделі в усіх завданнях.
Геометричне вирівнювання та розуміння мовних інструкцій є його сильними сторонами, але коли йдеться про безперервний контакт і багатокрокове фізичне маніпулювання, існуючі VLA все ще мають чимало простору для вдосконалення.
Ван Цянь, засновник X Square Robot, дотримується думки, що для того, щоб загальні великі моделі увійшли у втілений ШІ, їм все ще доведеться зіткнутися з інфраструктурними питаннями, такими як дані роботів, оцінювання в реальному світі, апаратне забезпечення, симуляція та розгортання.
Ці труднощі не зникнуть автоматично лише тому, що хтось має потужнішу мовну модель.
Питання в тому, чи те, що Astra не може зробити добре сьогодні, раптом стане досяжним завтра?
Наразі ще однією поширеною критикою Astra в галузі є те, що швидкість її виведення занадто повільна.

Чень Тяньсін також помітив, що хмарний API GPT-6 Astra має відносно високу затримку виведення, що є реальною перешкодою для керування роботом у режимі реального часу із замкнутим циклом.
Подумайте: якби робот мав чекати, поки велика модель довго думає перед кожною дією, ймовірно, було б важко задовольнити вимоги реальних сценаріїв.
Але Чень Тяньсін вважає, що ця проблема не є фундаментальною перешкодою; вже існує багато готових рішень для розгортання LLM на пристрої, включаючи такі технології, як квантування моделей, дистиляція та механізми виведення на пристрої. Якщо великі модельні компанії вважатимуть робототехніку важливим комерційним сценарієм, вони зможуть використати наявний технологічний стек для завершення оптимізації затримки.
За цією проблемою стоїть поняття, яке дуже легко сплутати: «частота виведення моделі» та «частота керування роботом» — це не одне й те саме.
Інженер втілених моделей, який побажав залишитися анонімним, розповів QbitAI:
Повільне виведення все ще може дозволяти швидке керування; жертвують лише швидкістю реакції. Для конвеєрних завдань, які більше залежать від ритму, це насправді не має значення.
Наприклад, у сортуванні експрес-посилок роботам потрібно безперервно й стабільно захоплювати та розміщувати об'єкти. Високорівнева модель відповідає за розуміння завдання та планування дій, тоді як низькорівнева система керування виконує команди керування з вищою частотою.
Доки завдання дозволяє завчасне планування або має певну толерантність до затримки реакції, велика модель не обов'язково повинна брати участь у кожному циклі низькорівневого керування.
Звичайно, для завдань, пов'язаних із високошвидкісними динамічними змінами та складним контактом, швидкість реакції все ще важлива.
Але принаймні повільний висновок не обов'язково означає, що керування роботом не є швидким.

Різноманітні недоліки, які виявляють сьогоднішні загальні великі моделі, не можна безпосередньо розглядати як захисний рів, на який компанії втіленої робототехніки будуть спиратися для виживання в майбутньому.
Для компаній втіленої робототехніки ця істина дещо болісна для слуху.
Але факти є. Цього року OpenAI вже почала наймати велику кількість посад, пов'язаних з робототехнікою.
Якщо загальні моделі в майбутньому поглинуть більше даних про маніпуляції роботів, межі можливостей, які спочатку належали спеціалізованим втіленим моделям, можуть продовжувати звужуватися.
Чи ще мають компанії втіленої робототехніки можливості? Чи все ще необхідно розробляти власне моделювання?
Судження Чень Тяньсіна полягає в тому, що можливість для компаній втіленої робототехніки полягає не в тому, чия модель розумніша, а в тому, хто може створити кращі "економічні вигоди".
Цей рахунок легко підрахувати.
На високостандартизованій промисловій складальній лінії, де роботи щодня повторюють одні й ті самі дії, клієнти найбільше дбають про відсоток успіху, час циклу, стабільність і вартість.
Якщо витратити кілька центів на виклик моделі може стабільно виконати завдання, навіщо наполягати на витраті кількох доларів на виклик GPT-6 Astra?
Навіть якщо потрібен певний рівень інтелекту та здатності до узагальнення, невелика модель, яка була спеціально оптимізована, може бути більш економічною, ніж прямий виклик Astra.

Звичайно, якщо це домашній сервісний робот, ситуація інша.
Сьогодні він прибирає стіл, завтра шукає предмети, а післязавтра надходить нове завдання, якого він ніколи не бачив.
У такому відкритому середовищі, чим більше завдання різняться, тим вищі вимоги до розуміння, планування та здатності до узагальнення. Сильніша загальна модель може, навпаки, мати більше переваг.
6 листопада Чень Тяньсін пояснив різницю у своєму особистому блозі за допомогою двох осей.
Ліворуч — "вимоги сценарію", праворуч — "можливості моделі". Чим вище, тим більше акцент на універсальності; чим нижче, тим більше акцент на ефективності.

△Блог Чень Тяньсіна
"Відкриті завдання можуть більше покладатися на загальні моделі, стабільні завдання можуть використовувати правила або легковагі стратегії, а сценарії між ними залишають простір для моделей, оптимізованих під сценарій", — сказав Чень Тяньсін.
На мою думку, поєднання двох осей зводиться до одного речення:
Якщо щось можна вирішити за допомогою правил/легковагих стратегій, немає потреби залучати велику модель; якщо завдання можна виконати за допомогою невеликої моделі, немає потреби викликати Astra щоразу.
І навпаки, якщо завдання занадто різняться, спеціалізованим моделям потрібно безперервно збирати дані та перенавчатися, тому прямий виклик загальної моделі може бути більш рентабельним.
Визначення того, який підхід обрати, зрештою вимагає підрахунку повного економічного рахунку.
Який відсоток успіху одного завдання? Скільки часу це займає? Скільки ручного втручання потрібно після збою? Скільки коштують збір даних, навчання моделі та довгострокове розгортання?
Ці конкретні цифри визначають, чи має роботизована система комерційну цінність.
Отже, річ не в тому, що власна розробка неважлива, а в тому, що «напрями власної розробки» компаній у сфері втіленого штучного інтелекту потрібно перевпорядкувати.
Можливості, з якими загальні моделі вже добре справляються, як-от розуміння мови та планування завдань, можна розглядати для безпосереднього використання; питання, пов'язані з фізичною взаємодією, контролем конкретного тіла, адаптацією до реальних сценаріїв і ефективністю розгортання, все ще потребують значної спеціалізованої дослідницької та розробницької роботи.
Щодо того, чи потрібно продовжувати навчати більшу фундаментальну модель втіленого штучного інтелекту з нуля, це залежить від того, чи може вона забезпечити достатньо очевидні та достатньо тривалі переваги в реальних завданнях.
Деякі друзі з галузі поскаржилися Quantum位, що багато команд у сфері втіленого штучного інтелекту все ще мають досить сильний академічний склад розуму, постійно думають про створення моделі загального інтелекту і хотіли б запхати всі завдання у власну модель.
Але ситуація зараз змінилася. GPT-6.2 Astra ось-ось з'явиться.
Якщо дослідницький напрям компанії відірваний від її цільової галузі, то хоч би як гарно була навчена модель, комерційний цикл може й не спрацювати.
Ще одне
За останні 60 днів багато практиків галузі втіленого штучного інтелекту під час приватних розмов усе ще перебувають у розгубленості.
Просто в публічних умовах, коли йдеться про захист власних інтересів і позицій, їм все ще доводиться стояти на своєму до кінця.
Певно те, що GPT-6 Astra справді порушив початковий ритм галузі втіленого штучного інтелекту...
Ефект Матвія, переоцінка галузі після IPO Unitree, RSI, що стає новою гарячою точкою... усе це, наклавшись одне на одне, зрештою сформувало нещодавні галузеві настрої—
«Інвестори починають припиняти інвестувати у втілений штучний інтелект».
Можливо, це дещо перебільшено, але цілком правда те, що стартапи у сфері втілених інтелектуальних роботів прощаються з етапом демонстрацій і спалювання інвестицій.
Відбірковий раунд битви сотні машин уже розпочався.
Ця стаття походить із публічного акаунта WeChat «Quantum位» (ID: QbitAI), автор: Focus on Frontier Technology