Не может быть, неужели бенчмарки действительно развились до такого уровня???
На этот раз речь уже не о решении тренировочных задач — ИИ просто дают набор экспериментальных условий и позволяют ему самостоятельно проводить исследования и заранее предсказывать результаты реальных лабораторных экспериментов...
Например, если одну и ту же реакцию проводят в нескольких различных условиях, в каком из них получится больше целевого продукта? Среди партии вариантов антител какой из них будет иметь более высокий уровень экспрессии?
Ответы сначала скрываются, а после того, как ИИ сдаёт свою работу, фактические измеренные результаты сравниваются с ней.
И знаете что, это на самом деле то, что стоит проверять прямо сейчас.
За последние два года подход AI for Science становился всё более глубоким — ИИ уже может самостоятельно искать литературу, использовать программное обеспечение и непрерывно работать часами напролёт, чтобы выполнить задачу анализа.
Естественно, все начали переходить к следующему этапу: какие именно научно-исследовательские способности мы на самом деле хотим, чтобы ИИ обладал?
Предсказание результатов лабораторных экспериментов — один из пунктов с немалой практической ценностью.
Оно требует, чтобы ИИ понимал цель эксперимента и выкапывал соответствующие механизмы из существующих знаний, чтобы он мог лучше помогать исследователям отбирать направления исследований, достойные дальнейшего изучения.
Новый бенчмарк Science Prediction Universe (сокращённо SPU), возглавленный и запущенный UniPat AI, остро это заметил.
116 задач, 4 207 лабораторных экспериментов, охватывающих химию, материаловедение, биологию и медицину. Консультанты бенчмарка и партнёры по лабораторным экспериментам также происходят из таких университетов, как Стэнфорд, Корнелл и Гарвард, а также из передовых исследовательских институтов и биотехнологических компаний в этой области.
Модель каждый раз следует системе 8-часового рабочего дня, оснащена H20, а затем самостоятельно решает, как использовать ресурсы поиска и вычислений для формирования экспериментальных предсказаний.
Результаты удивили всех.
Даже такие сильные модели, как Opus 5.5 и GPT-6 Astra, согласно данным, всё ещё очень далеки от того, чтобы действительно быть способными осуществлять предсказание...
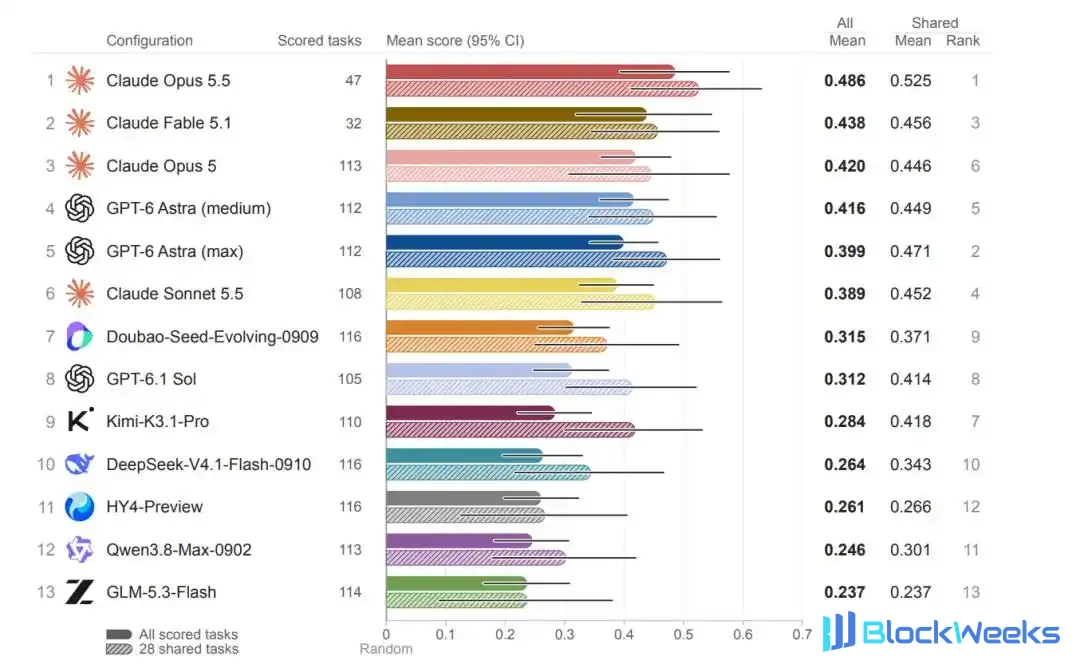
△Средние баллы каждой конфигурации по всем оценённым задачам
Надо сказать, SPU подал всем исследовательским моделям трудное блюдо.
Те исследовательские способности, которые раньше были невидимыми и неосязаемыми, теперь стали числовыми значениями, которые можно единообразно оценивать и непрерывно изучать.
Что касается того, как научное суждение ИИ развивается шаг за шагом, теперь есть более конкретная основа для обсуждения.
Предсказание лабораторных экспериментов: стоит отдельного экзамена для моделей
Возвращаясь к предсказанию лабораторных экспериментов — прежде всего, это действительно не новый вопрос.
В истории науки было много таких моментов: суждение выносится до эксперимента, а затем процессу предоставляется решать — если оно верно, оно остаётся; если ошибочно, оно опровергается.
Конкретная логика суждения составляет вкус учёного.
С достаточно хорошим вкусом и достаточно точной интуицией учёные могут быстрее получать крупные результаты, экономя при этом драгоценные экспериментальные ресурсы.
В конце концов, всего один эксперимент в мокрой лаборатории — для химии нужно подготовить реагенты, задать условия реакции, а затем разделить продукты; для биологии также приходится проходить через длительную экспрессию белков... Временные и инструментальные затраты сами по себе довольно дороги, а если результаты неидеальны, приходится повторять это снова и снова в течение нескольких раундов.
Поэтому прогнозирование перед началом — это самый ценный этап в процессе исследования.

Единственное отличие в том, что раньше это делали исключительно сами учёные, а теперь, в эпоху ИИ, модели также должны обладать этой способностью, и им тоже нужен экзаменационный лист, который может их оценить.
Существующие бенчмарки всё ещё не могут полностью охватить это. Например, BrainBench позволяет моделям напрямую оценивать результаты экспериментов; ScienceAgentBench сосредоточен на выполнении анализа на существующих данных; а бенчмарки долгосрочных задач, такие как Terminal-Bench 4.0 и Long-Horizon-TB, в основном используют предустановленные тесты для проверки выходных данных задач.
SPU отличается от всех них.
Он делает больший акцент на проверке автономного исследовательского процесса ИИ вместе с прогнозированием результатов мокрой лаборатории, охватывая как качество прогнозирования, так и способность использовать научные инструменты и выполнять долгосрочные задачи.

△Диаграмма создана с помощью ИИ
Такого рода оценка также была организована SPU в чёткие задачи.
100 публичных задач были взяты соответственно из 85 недавно опубликованных статей. Эксперты в предметной области упорядочили варианты-кандидаты, материалы, условия и методы измерения из исследования, сохранив полные количественные результаты в качестве основы для оценки.
Кроме того, 16 приватных задач происходят из четырёх групп неопубликованных совместных экспериментов в мокрой лаборатории, касающихся VHH-наноантител, условий реакции, электролитов и вариантов Магролимаба.
Всего 32 подобласти и 4 207 экспериментов, среди которых публичные исследования предоставляют междисциплинарные источники задач, измеренные результаты скрыты от моделей, а неопубликованные эксперименты добавляют тесты, независимые от ответов в публичных статьях.
В определённой степени это может предотвратить то, что модели уже видели вопросы заранее.

△Охват и источники задач SPU
Процесс отбора вопросов также довольно продуман.
Эксперты отдают приоритет исследованиям с полными измерениями и чёткими условиями; простые вопросы, которые можно упорядочить по одной тенденции, сразу исключаются, а вопросы со слишком близкими значениями также считаются имеющими малую справочную ценность.
Вопросы, которые в итоге остаются, все сложнее и более различительны.
В ходе конкретного процесса прогнозирования модель должна работать по восемь часов каждый раз, оснащённая 8-ядерным процессором, 16 ГиБ памяти и одним H20, при этом ей разрешено искать в интернете и устанавливать научно-исследовательское программное обеспечение.
В течение этого периода модель будет самостоятельно собирать доказательства, выбирать вычислительные методы и в конечном итоге представлять прогнозируемый рейтинг от низкого к высокому для каждой группы сравнения.
Чтобы предотвратить загрязнение памяти, процесс оценки также полностью проводится в независимом офлайн-контейнере; ИИ запрещено извлекать исходные результаты исследований, а выходные данные инструментов автоматически сканируются для выявления идентификаторов, таких как DOI и название исходной статьи.
Наконец, система использует коэффициент корреляции Спирмена для сравнения прогнозируемого рейтинга с измеренным рейтингом.
Чем ближе коэффициент к 1, тем ближе рейтинг к экспериментальным результатам.

△Процесс оценки SPU
Интересно, что SPU также уделяет внимание многим деталям, которые не учитывались в эталонных тестах.
Например, что касается итогового балла, SPU учитывает, не мог ли он быть получен случайно, на случай если это была слепая кошка, наткнувшаяся на дохлую мышь.
Поэтому он дополнительно генерирует 4000 случайных рейтингов для каждого вопроса, использует 95-й процентиль в качестве порога случайного уровня и проверяет, значительно ли представленный моделью результат превышает этот ориентир. Для разных задач также существуют соответствующие базовые ориентиры.
Дизайн всего SPU можно назвать научно строгим.
Модель должна шаг за шагом внутри него самостоятельно определять, что стоит вычислять, и представлять свой окончательный прогноз.
Этот дизайн не только помогает измерить текущую способность ИИ к прогнозированию в мокрой лаборатории, но и указывает направление для последующих исследовательских групп по постоянному совершенствованию экспериментов с помощью унифицированных метрик.
Тем не менее, далее мы можем вместе взглянуть на отчетные карточки первой партии передовых моделей. Детали вполне заслуживают отдельного обсуждения.
Новый тест заставляет передовые модели коллективно провалиться
Первый раунд систематической оценки SPU охватывает 12 передовых моделей и 13 конфигураций. Конфигурации здесь относятся к модели, интенсивности рассуждений и используемой модельной структуре.
Сначала поговорим об общих результатах.
Одним предложением: ни одна из них не хороша.
По всем оцененным задачам наивысший средний балл был у Claude Opus 5.5 — 0,486 балла. Но даже для него только половина задач превысила случайный уровень.
Среди 13 конфигураций это почти всегда так; доля задач, превышающих порог случайного уровня, составляет лишь от 34% до 52%.
Иными словами, всем представленным моделям еще предстоит пройти долгий путь, прежде чем они смогут действительно надежно прогнозировать в мокрой лаборатории.

△Сравнительный анализ поведения ведущей и отстающей групп
Однако между моделями также есть различия, и средняя производительность может быть разделена на два уровня:
ведущая группа (6 моделей) и отстающая группа (7 моделей).
При сравнении на одних и тех же вопросах ведущая группа в среднем все еще примерно на 0,15 балла выше, чем остальные семь.
Есть еще одна деталь, заслуживающая внимания. Около 9% задач в ведущей группе получили балл ниже 0, тогда как для остальных семи конфигураций эта доля может достигать 22%.
Здесь 0 относится к среднему баллу случайного допустимого рейтинга; отрицательный балл означает, что прогноз отрицательно коррелирует с фактическим рейтингом.
Откуда именно возникает разрыв? Исследовательская группа копнула на шаг глубже.
Сначала они объединили предсказания других моделей по одному и тому же вопросу в эталонный рейтинг, затем попарно сопоставили эксперименты, сравнили их с измеренными результатами и проверили, правильно ли каждая модель по отдельности их ранжировала.
На парах экспериментов, где эталонный рейтинг был верным, ведущая группа ранжировала их правильно в 86% случаев, тогда как остальные семь конфигураций достигали 78%; для пар экспериментов, где эталонный рейтинг был неверным, обе группы независимо ранжировали их правильно примерно в 30% случаев.
Таким образом, фактически часть преимущества ведущей группы проявляется именно там, где предсказания совместно верны; в этой части ведущая группа всегда более стабильна.

Что касается того, почему модель отклоняется от правильного суждения, записи запусков содержат более конкретные подсказки.
Возьмём в качестве примера задачу решения. Для одной и той же реакции полимеризации последовательно меняли 12 растворителей, и задача требовала ранжирования по массе в конечном итоге выделенного полимера.
Opus 5.5 набрал 0,874, а Qwen3.8 — -0,126. 12 кандидатных условий растворителей были сопоставлены попарно, всего 66 пар; первый правильно ранжировал 56 пар, а второй — 30 пар.

△Два запуска Opus и Qwen на одной и той же задаче
Анализ показал, что это связано с тем, что они с самого начала различались в факторах, на которые обращали внимание:
Qwen3.8 в основном ранжировал исходя из того, сколько этилена может растворить растворитель, тогда как Opus 5.5 уделял больше внимания смешиваемости сырьевых материалов и совместимости катализатора в растворителе.
Хотя Qwen3.8 также обнаружил эту проблему в процессе вычислений, в конечном итоге ему не удалось напрямую изменить основу ранжирования, окончательно принятую моделью.
Следовательно, этап, на котором наиболее вероятны ошибки предсказания, — это шаг выбора основы для суждения. Модели также нужно научиться корректировать метод ранжирования в реальном времени в соответствии с подсказками, чтобы эти находки могли действительно влиять на ответ.
Если разобрать подробнее, эти различия также варьируются в зависимости от конкретной дисциплины и задачи.
Среди оценённых результатов по каждой дисциплине в публичных задачах наивысший средний балл по химии был у Opus 5.5, по материаловедению — у Fable 5.1, по биологии — у GPT-6 Astra Medium, а по медицине — у Opus 5.
P.S. Fable 5.1 и Opus 5.5 продемонстрировали поведение отказа от ответа.

△Баллы каждой модели по четырём дисциплинам
Так что если вы готовитесь привлечь ИИ к определённому типу исследований, возможно, сначала стоит найти связанную задачу и протестировать её с помощью SPU, и только после подтверждения того, что модель действительно применима, переходить к формальным экспериментам.
Результаты приватных задач делают этот момент ещё более наглядным.
Среди 13 конфигураций у 12 средние баллы были значительно выше случайного ранжирования, и между конфигурациями не было обнаружено очевидных различий. Напротив, вариация, вносимая разными задачами, была особенно заметной.
Для одной и той же партии электролитов при прогнозировании ионной проводимости коэффициенты ранговой корреляции 13 конфигураций были сосредоточены в диапазоне от 0,89 до 0,95; при переходе к электрохимическому окну оценки 12 конфигураций, получивших баллы, варьировались от -0,55 до 0,07, ни одна из них не превысила порог случайного уровня.
Модель не менялась, но как только изменилась цель измерения, распределение оценок также явно изменилось.
Поэтому в следующий раз, когда вы будете оценивать модель, говорить только о том, что она хороша в химии, недостаточно конкретно; вам также нужно увидеть, какую конкретную цель измерения и какие экспериментальные условия она учитывает.

△Прогнозная производительность каждой модели на 16 частных задачах
Вот ещё одна довольно противоречивая вещь:
Вообще говоря, предоставление модели большего времени и более высокой интенсивности рассуждений должно приводить к дальнейшему росту оценки, верно?
Все обычно так думают, и все так делают.
Но знаете что? Как только результаты SPU были получены, они прямо дали нам пощёчину —
При одинаковых 8 часах вычислений исследовательская группа переключила GPT-6 Astra со средней интенсивности рассуждений на максимальную. Медианное время выполнения при максимальной интенсивности увеличилось до 4,8 раза, а медианная стоимость API также выросла до 5,3 раза.
Но оценка прогноза... почти не сдвинулась.
А? Исследовательская группа даже специально вернулась, чтобы просмотреть записи запусков модели.
И вот, на 79 завершённых задачах GPT-6 Astra при максимальной интенсивности рассуждений обычно уже давала ответ к медианным 26% времени выполнения.
Модель после этого тоже не бездействовала; она продолжала вычислять и пересматривать, но всё это были мелкие корректировки, которые не проявились как различия в результатах.
Иными словами, более высокая интенсивность рассуждений не обязательно делает результаты лучше.

△Вложения и производительность GPT-6 Astra при двух уровнях интенсивности рассуждений
Это явление также служит напоминанием для распределения ресурсов модели: если вы хотите добавить вычислений, не бросайтесь вслепую — это отнимает время, силы и может даже не окупиться.
Вместо этого можно более внимательно изучить записи запусков, сначала полностью понять, какому именно суждению соответствуют вновь добавленные доказательства, а затем целенаправленно наращивать вычислительную мощность локально.
На самом деле похожее явление проявляется и в использовании инструментов.
В каждом запуске медианное количество категорий методов, используемых GPT-6 Astra Max, равно 4, тогда как для Medium — 1, однако значимых различий в оценках между двумя конфигурациями обнаружено не было.
Причина во многом та же: хорошие инструменты не использовались там, где это было наиболее важно.
Например, при выборке Монте-Карло, хотя модель вызывает этот инструмент большую часть времени, он лишь добавляет погрешность к итоговому ранжированию и не влияет напрямую на сам результат.

△Вызов инструментов научных вычислений
Так что на самом деле использовать инструменты больше — не значит лучше, чем использовать их точно.
Использование GPU также даёт интересный ракурс.
Даже при достаточной вычислительной мощности GPU фактически успешно выполнились на GPU лишь 255 запусков, менее одной пятой.
У разных моделей и в разных дисциплинах запуски на GPU различаются, поэтому простое рассмотрение числа вызовов GPU едва ли может указывать на исследовательские способности модели.
Чтобы судить, помогла ли вычислительная мощность, всё ещё нужно увидеть, для каких вычислений она использовалась, помогли ли результаты вычислений с прогнозированием и как эти результаты повлияли на итоговый рейтинг.
Ключевым по-прежнему остаётся направить вычислительную мощность на физические величины, релевантные рейтингу, чтобы модель могла выполнять прогнозирование более точно.

△Статистика использования GPU
Если рассматривать вместе с затратами, средняя стоимость API за запуск по конфигурациям составляет от $0,22 до $65,91, разрыв — целых 300 раз.
Это означает, что SPU предоставляет как прогностическую производительность, так и стоимость вызова, хороший ориентир для команд, готовящихся развертывать исследовательские модели.
От общих оценок к траекториям по каждому вопросу — SPU раскрывает различия моделей в каждой детали научного суждения, например в вычислительной мощности и затратах.
Насколько значения, вычисленные ИИ, на самом деле помогают прогнозированию; когда прогноз ошибочен, какие суждения следует пересмотреть... всё это можно дополнительно проанализировать, объединив результаты экспериментов с записями запусков.
Таким образом, у следующего раунда улучшений есть ясное направление для попыток:
Согласно SPU, модель может более своевременно обнаруживать ошибочные гипотезы и сохранять или изменять рейтинги с большей обоснованностью. После изменений её снова помещают в ту же задачу, чтобы увидеть, станут ли прогнозы точнее.
Внести «проверку понимания» в экзаменационную аудиторию модели
Можно сказать, что SPU в высокой степени согласуется с закономерностями развития AI4S.
Оценка AI4S постепенно углубляется в реальные экспериментальные стадии, и бенчмарки, ориентированные на выполнение экспериментов, также начали появляться в этом году.
Но помимо выполнения, прогнозирование, как неизбежный этап исследовательского процесса и наиболее трудно поддающийся количественной оценке, наконец получило измеримый способ.
Преимущества отражаются в двух аспектах:
Исследователи благодаря этому могут анализировать, какие измеряемые цели легче прогнозировать, какие задачи различаются сильнее всего и как формируется ошибочное суждение. Это может сэкономить дорогостоящие и ценные экспериментальные ресурсы и сократить время принятия решений.
Для разработки моделей это также даёт более конкретный ориентир для улучшения.
По мере увеличения типов экспериментов оценка также может отвечать на более конкретные вопросы: для каких материалов, экспериментальных условий и методов измерения рейтинги, выдаваемые ИИ, более надёжны и более заслуживают ссылки.
Таким образом, учёные могут непрерывно накапливать прогресс вокруг вопросов одного и того же типа.

На самом деле SPU — лишь верхушка айсберга в серии оценок реальной работы UniPat AI:
- ScienceVision: сосредоточен на том, как модели получают доказательства из трёхмерных научных объектов и отвечают на вопросы;
- PaperBenchX: превращает опубликованные исследования в исполняемые, проверяемые задачи по воспроизведению статей;
- SaaS-Bench и EvoCode-Bench: соответственно исследуют реальные программные процессы и разработку, когда требования постоянно меняются. ...
Эти работы охватывают научные исследования, офисную работу и разработку программного обеспечения, и все они объединены вниманием к тому, как ИИ выполняет задачи после вхождения в конкретную работу и как проверяются результаты.
Это также косвенно отражает, что UniPat AI обладает уникальным отраслевым видением и дальновидным суждением относительно движения ИИ к научно-исследовательской практике и даже к реальному миру.
UniPat AI также демонстрирует новый тип модели сотрудничества с ИИ:
Эксперты предметной области участвуют в отборе и проверке задач, партнёрские лаборатории предоставляют неопубликованные задачи, а проектная команда организует эксперименты из разных дисциплин в единые оценочные задачи.
Взяв SPU в качестве примера, им руководит UniPat AI, а учреждения членов консультативного совета включают Стэнфорд, Корнелл, Гарвард, UIC, Пекинский университет, HKUST и FutureHouse. Соисполнители по влажной лаборатории из Yourui Saishi, Aibotaike, Deep Principle и Enhe Biology участвовали в соответствующей экспериментальной работе.
Междисциплинарные знания и экспериментальные ресурсы таким образом входят в единый процесс оценки. SPU несёт в себе не только отбор проблем, но и представляет сотрудничество, необходимое для организации научно-исследовательских проблем в исполняемые задачи.
В настоящее время 100 публичных задач, связанных с SPU, планируется выпустить в виде полных пакетов задач Harbor; 16 приватных задач останутся приватными для контролируемой оценки. Как набор данных, так и код были открыты.
Следует признать, что сегодняшний ИИ перед лицом этого механизма SPU всё ещё остаётся лишь новичком.
Он может использовать инструменты со скоростью молнии и в течение 8 часов установить три набора программного обеспечения, завершить запуск DFT, а затем запустить Монте-Карло, но в наиболее критичном суждении он ещё не научился задавать себе один вопрос: является ли величина, которую я вычисляю, именно той величиной, которую эксперименту действительно нужно измерить.
Но по мере накопления таких задач будет становиться ясным и то, какую научно-исследовательскую работу сможет взять на себя ИИ.
SPU измерил это расстояние, и каждый последующий экзамен является записью того, как ИИ приближается к реальному экспериментальному стенду.
Эта статья взята из публичного аккаунта WeChat «Quantum位» (ID: QbitAI), автор: Focus on Frontier Technology