
Etwa 90 % des Codes von Claude Code selbst wurde bereits an Claude zum Schreiben übergeben.
Da nun die KI den Code schreibt, ist die Zahl der Änderungen entsprechend gestiegen: Von Juni bis September hat sich die Zahl der in die Codebasis eingefügten PRs mehr als verdoppelt.
Bei Anthropic insgesamt stieg die Zahl der täglich in die Hauptcodebasis eingefügten Änderungen von etwa 2.500 im Mai auf über 30.000 im September.
Können Menschen bei so viel Code noch mit dem Lesen Schritt halten? Und wenn sogar die Überprüfung an die KI übergeben wird, wer beurteilt dann, ob sie einen Fehler gemacht hat?
Am 15. Oktober hat das Claude Code-Team seinen internen Code-Review-Prozess öffentlich offengelegt und dabei enthüllt, dass die Zahl der PRs sich zwar verdoppelte, der Anteil der PRs, die zurückgerollt werden mussten, relativ dazu jedoch tatsächlich um mehr als 40 % sank.
Sie erreichten dies durch sechs Prüfebenen sowie einen Fallback-Mechanismus zur schnellen Erkennung und schnellen Rückabwicklung.
Die Einschätzung des Claude Code-Teams lautet:
In diesem Maßstab ist eine zeilenweise menschliche Überprüfung nicht mehr realistisch.
Doch sie haben die Überprüfung nicht abgeschafft; stattdessen haben sie den Großteil der Arbeit des Codelesens an Maschinen übergeben.
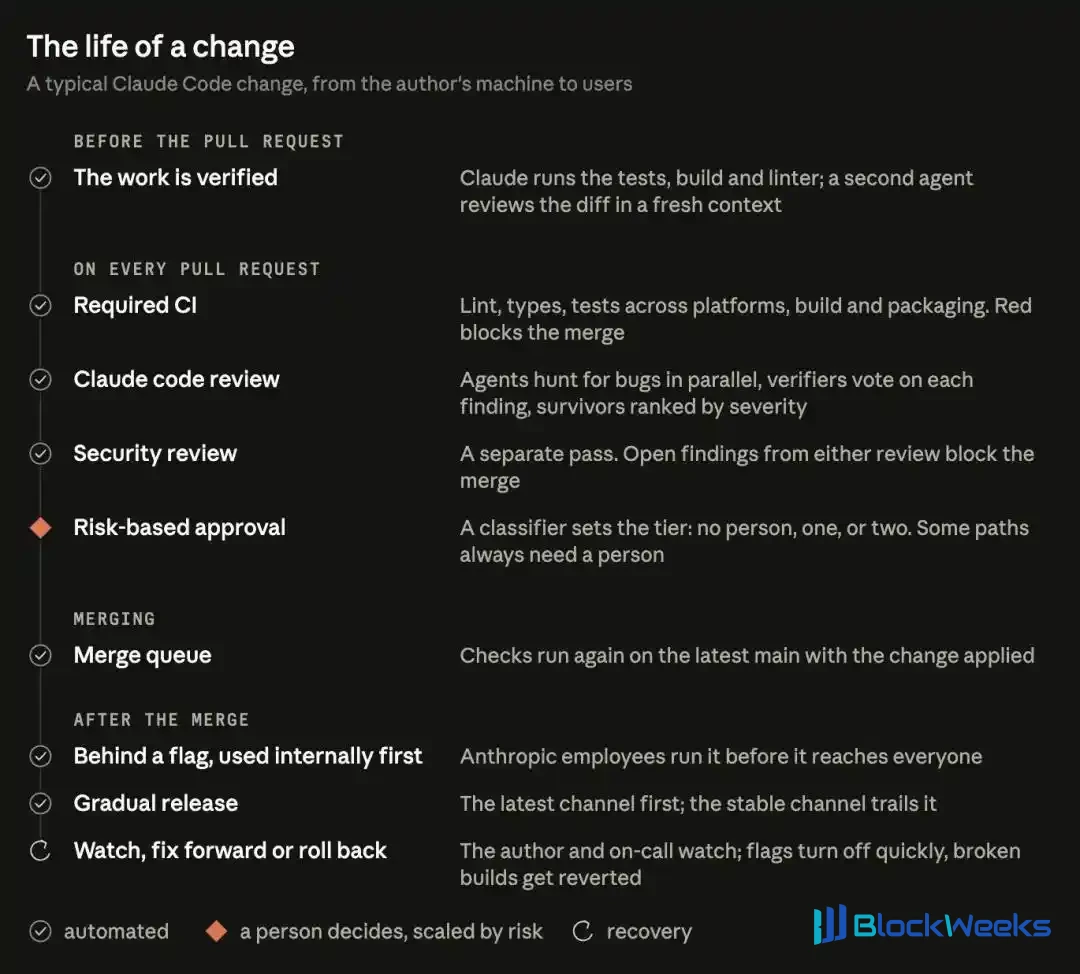
Bevor ein Stück von KI geschriebener Code live geht, muss es zunächst Tests durchlaufen, eine KI- und Sicherheitsüberprüfung bestehen und dann wird je nach Risiko entschieden, ob eine menschliche Freigabe erforderlich ist.
Aus Sicht des Claude Code-Teams ist „Hat jemand diesen Code gelesen“ keine präzise genug gestellte Frage.
Die eigentliche Frage sollte lauten:
Was könnte bei dieser Änderung schiefgehen, und wenn es schiefgeht, welche Prüfung sollte es stoppen?
Vor der menschlichen Überprüfung , präsentiert die KI zuerst die Verifikationsergebnisse
Eine einzelne Änderung muss sechs Prüfungen bestehen, mit einem Sicherheitsnetz am Ende.
Das erste Tor kommt vor dem Erstellen eines Merge-Requests (PR).
Claude muss Tests ausführen und den Build abschließen; bei Änderungen, die die Benutzeroberfläche betreffen, muss es außerdem Screenshots machen, um sie mit den Design-Mockups zu vergleichen.
Als Nächstes wird ein Sub-Agent mit einem frischen Kontext entsandt, um den Code-Diff zu überprüfen; er war nicht am Schreiben des Codes beteiligt und ist ausschließlich darauf ausgerichtet, Fehler zu finden.
Die offizielle Anforderung ist sehr klar:
Claude muss die ausgeführten Befehle und deren Ausgabe vorlegen; allein die Antwort „alle Tests bestanden“ zählt nicht.
Gewöhnliche Entwickler können es genauso machen: Wenn man der KI eine Aufgabe gibt, sollte man auch klar angeben, wie die Abnahme verifiziert wird.
Das zweite Tor ist die KI-Überprüfung am PR.
Mehrere Agenten suchen parallel nach Fehlern, und eine weitere Gruppe stimmt ab, um sie zu verifizieren. Erst wenn genügend Stimmen erreicht sind, wird das Problem im PR veröffentlicht.
Kommentare, die nur den Code-Stil, diagnostische Hinweise oder Code-Bereinigung betreffen, werden nicht im PR veröffentlicht und direkt herausgefiltert.
Als dieses Review-System im März erstmals eingeführt wurde, stieg der Anteil interner PRs, die inhaltliche Review-Kommentare erhielten, von 16 % auf 54 %.
Das dritte Gate ist die Sicherheitsüberprüfung.
Innerhalb des Teams gilt: Solange Befunde aus dem Code-Review oder der Sicherheitsüberprüfung ungelöst bleiben, kann der PR nicht gemergt werden: entweder beheben oder mit schriftlicher Begründung schließen.
Das vierte Gate sind die Continuous-Integration-(CI-)Prüfungen, einschließlich Codestandards, Typprüfung, Plattformtests und Build-Paketierung.
Eine einzige gewöhnliche Änderung an einem Kommandozeilenwerkzeug (CLI) muss möglicherweise Dutzende von Prüfungen durchlaufen, bevor sie zur menschlichen Überprüfung übergeben wird.
Wiederkehrende Probleme müssen auch zur Grundlage für die nächste Prüfungsrunde werden.
CLAUDE.md zeichnet Projektkonventionen auf, und REVIEW.md teilt dem Reviewer mit, worauf er sich konzentrieren und was er überspringen kann, damit die diesmal gefundenen Probleme zur Erfahrung für das nächste Review werden.
Wenn derselbe Kommentar zum dritten Mal erwähnt wird, sollte er in die Regeln geschrieben werden.
Das fünfte Gate ist die menschliche Genehmigung, die das entscheidendste ist; wir werden es im nächsten Abschnitt ausführlich besprechen.
Das sechste Gate ist Merge und Release.
Nachdem eine Änderung die vorherigen Gates passiert hat, muss sie noch in die Merge-Warteschlange eintreten und auf ihre Reihenfolge warten.
Wenn sie an der Reihe ist, platziert das System sie auf der neuesten Version des Hauptzweigs, und alle Prüfungen laufen erneut.
Dieser Schritt schützt davor, dass „jeder Teil für sich in Ordnung ist, aber Probleme entstehen, wenn sie kombiniert werden“.
Nach dem Merge werden neue Funktionen auch nicht sofort an alle Nutzer ausgeliefert.
Sie werden zunächst hinter Feature-Flags verborgen und nur für die internen Mitarbeiter von Anthropic geöffnet. Mitarbeiter nutzen sie täglich intensiv und stoßen oft früher auf Probleme als externe Nutzer.
Und das Feature-Flag ist wie ein Hauptschalter: Ohne Code zu ändern oder eine Version neu zu veröffentlichen, kann es entscheiden, ob eine Funktion ein- oder ausgeschaltet ist.
Schließlich gibt es noch den Fallback.
Wenn ein Problem auftritt, zuerst den Hauptschalter umlegen.
Das Team wechselt sich wöchentlich mit dem Bereitschaftsdienst ab, und jede Incident-Postmortem muss fragen: An welchem Gate hätte dies gestoppt werden sollen?
Das Review ist also nicht verschwunden – es ist zu Schicht um Schicht von Prüfungen geworden, die sich durch Entwicklung, Merging und Release ziehen.
Wo liegen die Grenzen der Zero-Human-Genehmigung
Nachdem die ersten vier Gates alle grün sind, entscheidet das fünfte Gate anhand der Risikoeinstufung, wie viele Personen diese Änderung genehmigen müssen.
Dokumentation, Texte, nur intern sichtbare Funktionen und neue Änderungen, die hinter Flags verborgen sind, sind risikoarm; sobald die automatisierte Überprüfung und die Sicherheitsprüfungen bestanden sind, können sie die menschliche Genehmigung überspringen.
Gewöhnliche Produktänderungen sowie sensible Bereiche wie Caching, der Auto-Updater und System-Prompts benötigen eine Person.
Der Code mit dem höchsten Risiko sowie eine Handvoll festgelegter Pfade benötigen zwei Personen.
Auf den ersten Blick sind risikoarme Änderungen bereits „fahrerlos“?
So einfach ist es nicht.
Die Risikostufe wird durch die Änderung selbst bestimmt: Der erste Klassifikator liest den Code und legt das Risiko fest, und der zweite entscheidet dann, ob eine zusätzliche menschliche Genehmigung erforderlich ist.
Von Code-Ownern markierte sensible Pfade sowie alle CI-Workflow-Dateien müssen von einem Menschen überprüft werden.
Der leichte Genehmigungskanal hat ebenfalls eine Schwelle: Er ist nur für Personen auf der Liste der „vertrauenswürdigen Autoren“ des Repositorys offen; wer nicht auf der Liste steht, muss eine andere Person finden, die genehmigt.
Die Person, die die KI anleitet, Code zu schreiben, gilt selbst als Reviewer und muss die Verantwortung für die Änderung übernehmen, genauso als hätte sie den Code von Hand geschrieben.
Zero-Human-Genehmigung bedeutet nicht, dass niemand rechenschaftspflichtig ist.
Menschen müssen entscheiden, ob eine Funktion gebaut werden sollte, ob die Architektur vernünftig ist und ob die bestehenden Prüfungen das Risiko dieser Änderung abdecken können.
Das Claude-Code-Team hat also eine Regel: Der Code, den du mergest – wenn etwas schiefgeht, behebst du es normalerweise.
Bevor der Reviewer auf „Genehmigen“ klickt, muss er klar erklären können: Was haben diese Prüfungen verifiziert, und welche Risiken bleiben unentdeckt.
Wenn du es nicht erklären kannst, klicke nicht voreilig auf „Genehmigen“ – füge zuerst die notwendige Überprüfung hinzu.
Auch KI-Review kann scheitern
Auch automatisiertes Review kann sich selbst festfahren.
Ein PR für ein CLI-Projekt durchlief über Nacht mehr als fünfzig Runden Review und Korrekturen, bis der Autor schließlich manuell einen Halt veranlasste.
Ein Mensch kann ein kleines Problem in einer Sekunde ignorieren, aber die KI tut das nicht – sie geht pflichtbewusst daran, es zu beheben, und nach der Behebung gibt es einen weiteren Commit und eine weitere Review-Runde.
Das Team verwendete git blame, um zurückzuverfolgen, und stellte fest, dass von den Problemen, die der Reviewer wiederholt markierte, etwa 59 % alter Code waren, der bereits vor der ersten Review-Runde existierte. Es fand selten neue Bugs; in jeder Runde grub es nur ein paar weitere alte aus.
Später änderten sie vier Regeln:
Wenn es nach drei Runden immer noch nicht bestanden ist, erinnere den Autor daran, einen Schritt zurückzutreten und den Ansatz zu überdenken;
Nach den ersten paar Runden nur die neu hinzugefügten Änderungen überprüfen;
Probleme derselben Art auf einmal ansprechen;
Bereits angesprochene Probleme nicht wiederholen.
Die Wirkung war sofort spürbar.
Der Anteil interner PRs, die nach einer Runde Review und Korrekturen bestanden, stieg von 65 % auf 78 %; diejenigen, die fünf oder mehr Runden benötigten, fielen von 8,9 % auf 1,5 %; die durchschnittliche Anzahl der Reviews sank von 2,08 auf 1,32.

Nach der Anpassung der Re-Review-Regeln stieg die Bestehensquote nach einer Runde Review und Korrekturen von 65 % auf 78 %, und die durchschnittliche Anzahl der Reviews sank von 2,08 auf 1,32.
Die Kunst des Reviews besteht zur Hälfte darin, Probleme zu finden, und zur Hälfte darin, zu wissen, wann man aufhören muss.
Bedeutet mehrschichtiges Review, dass es narrensicher ist?
Anthropic selbst lieferte ein Gegenbeispiel.
Am 26. März lieferte Claude Code eine Optimierung aus: Wenn eine Sitzung länger als eine Stunde im Leerlauf ist, werden alte Reasoning-Aufzeichnungen einmalig bereinigt.
Aber ein Bug führte dazu, dass die Bereinigung nach der Wiederaufnahme einer Konversation bei jedem Turn ausgeführt wurde. Infolgedessen wurde Claude vergesslich, begann sich zu wiederholen und verwendete Tools abnormal. Der Bug wurde erst am 10. April behoben.

Nach dem Leerlauf hätten alte Reasoning-Daten nur einmal bereinigt werden sollen, tatsächlich wurde aber bei jedem Turn weiter bereinigt; der rote Kasten markiert den fälschlicherweise gelöschten Inhalt.
Die offizielle Postmortem-Analyse vom 23. April gab zu:
Diese Änderung durchlief mehrere Runden menschlichen und automatisierten Reviews; Unit-Tests, End-to-End-Tests und internes Dogfooding konnten es alle nicht erkennen, und allein die Bestätigung der Grundursache dauerte mehr als eine Woche.
Der Wendepunkt kam in der Postmortem-Analyse.
Das Team überprüfte den PR, der den Vorfall verursacht hatte, erneut mit Code Review; als ausreichender Kontext aus den relevanten Repositories bereitgestellt wurde, fand Opus 4.7 den Bug, während Opus 4.6 ihn nicht fand.
Dieser Backtest zeigte, dass sowohl die Modellfähigkeit als auch die Kontextvollständigkeit die Erkennungsergebnisse beeinflussen. Also ermöglichten sie dem Review, mehr Repositories einzubeziehen.
Heute wird jeder Vorfall zu einer Prüfungsfrage.
Das Team sammelt PRs, lässt Ingenieure, die mit dem Code vertraut sind, die darin enthaltenen Fehler einzeln bestätigen und stellt sie zu einem Testset zusammen.
Der Reviewer läuft jeden Tag gegen dieses Testset. Jedes Mal, wenn Prompts, Tools oder Modelle angepasst werden, wird es ebenfalls genutzt, um die Wirkung zu prüfen: Wenn sich die Punktzahl nicht verbessert, wird die Anpassung nicht übernommen.
Das Team hat auch nichts übertrieben dargestellt.
Nachdem Änderungen live gegangen sind, müssen Entwickler und Bereitschaftspersonal Anomalien weiterhin mithilfe von Daten-Dashboards erkennen.
Der „Circuit-Breaker“-Mechanismus, der Genehmigungen automatisch anhand von Kennzahlen wie der Rollback-Rate verschärft, ist noch nicht gebaut. Die Ingenieure wollen zuerst diese Absicherung hinzufügen, bevor sie mehr Änderungen durch eine Genehmigung ohne menschliches Eingreifen lassen.
Beim Review wird unweigerlich etwas übersehen; Erkennung und Behebung müssen ebenfalls Schritt halten.
Ein Mitglied des Claude-Code-Teams erklärte es so: Verlangsamen reduziert zwar Fehler, aber hauptsächlich, weil man von allem weniger macht. Deshalb investieren sie lieber Aufwand darein, Probleme schneller zu finden und schneller zu beheben.
Wenn eine Person Code mit KI schreibt, was akzeptiert werden muss
KI-Review gibt nur Meinungen ab; die Entscheidung treffen Sie weiterhin selbst.
Also stürzen Sie sich nicht darauf, „nicht hinsehen zu müssen“ – lassen Sie die KI stattdessen bei jeder Lieferung drei Fragen beantworten.
Erstens: Wie wurde es verifiziert?
Welche Prüfungen wurden ausgeführt, wie waren die Ergebnisse, und welche Fälle sind noch nicht abgedeckt.
Boris Cherny, der Schöpfer von Claude Code, hat gesagt, dass es möglicherweise das Wichtigste ist, Claude eine Möglichkeit zu geben, sich selbst zu verifizieren. Er schätzt, dass dies die Qualität des Endergebnisses auf das 2- bis 3-Fache des Ursprünglichen steigern kann.

Boris Cherny empfiehlt, Claude seine eigene Arbeit verifizieren zu lassen, um eine Rückkopplungsschleife zu bilden; er schätzt, dass die Qualität des Endergebnisses auf das 2- bis 3-Fache verbessert werden kann.
Zweitens: Was wird es beeinflussen?
Welche Benutzer, Daten und Berechtigungen von der Änderung betroffen sind.
Wenn Sie die KI eine Freigabefunktion zu einem Reporting-Tool hinzufügen lassen, müssen Sie klar fragen: Wer kann den Link öffnen, und was ist nach dem Öffnen sichtbar.
Drittens: Wie rollen Sie zurück, wenn etwas schiefgeht? Können Sie die neue Funktion mit einem Klick ausschalten und zur vorherigen Version zurückkehren.
Committen Sie vor dem Start einen Archivstand, und halten Sie jede Änderung so klein wie möglich. Zuerst in der Lage sein zurückzurollen, dann darüber sprechen, weniger zu reviewen.
Zusätzlich zu diesen drei Fragen kultivieren Sie drei weitere Gewohnheiten.
Erstens: Mit einem anderen „Gehirn“ reviewen.
In der Sitzung, in der Code geschrieben wird, übersieht man am leichtesten die eigenen Fehler.
Öffnen Sie eine neue Sitzung oder lassen Sie einen Sub-Agenten mit völlig frischem Kontext reviewen; die lokalen Befehle /code-review und /security-review können ebenfalls direkt ausgeführt werden.
Zweitens: Änderungen in Stufen einteilen.
Bei Textänderungen und Stilanpassungen nach bestandenen Prüfungen und bestätigter tatsächlicher Wirkung zusammenführen; bei allem, was Login, Zahlung oder Datenlöschung betrifft, muss ein Mensch die Schlüssellogik sorgfältig prüfen und gezielte Tests hinzufügen.
Anfangs strenger sein, und sobald die Verifikations- und Rollback-Prozesse reibungslos laufen, das manuelle Review von Änderungen mit geringem Risiko schrittweise reduzieren.
Drittens: Wenn es nach drei Runden nicht durchgeht, ändern Sie den Ansatz.
Wenn die KI drei Runden lang überarbeitet hat und immer noch im Kreis läuft, drängen Sie nicht auf eine vierte Runde – fragen Sie zuerst, ob der Ansatz selbst falsch ist.
Der wichtigste Punkt: Dass die KI „bestanden“ sagt, bedeutet nicht, dass Sie die Abnahme abgeschlossen haben.
Sie haben sie den Code schreiben lassen, und Sie müssen auch für die Ergebnisse nach dem Livegang verantwortlich sein.
Das Ziel des Claude Code-Teams ist es, dass die meisten PRs höchstens eine Person einbeziehen, während die Rollback-Rate und die Incident-Rate unter Kontrolle gehalten werden.
Menschliche Aufmerksamkeit sollte stärker auf die Bewertung von Risiken, die Bestätigung, ob Prüfungen ausreichend sind, und darauf gerichtet werden, wie Fehler nach ihrem Auftreten behoben werden können.
Man muss nicht jede Zeile Code lesen, aber für jedes Release muss jemand verantwortlich sein.
Referenzen:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Redakteur: Yuanyu
Dieser Artikel stammt aus dem WeChat-öffentlichen Account „Xinzhiyuan“ (ID: AI_era), Autor: ASI Revelation