Es ist erst zwei Monate her, dass GPT-6 Astra veröffentlicht wurde, und GPT-6.2 Astra steht bereits am Horizont.
Doch die Branche der verkörperten Intelligenz hat sich von dem vorherigen Schlag noch nicht erholt.
Alles geschah so plötzlich und erwischte die Menschen unvorbereitet.
Ich erinnere mich noch, als GPT-6 Astra zum ersten Mal herauskam, war eine Gruppe von Praktikern der verkörperten KI wie erstarrt. Besonders die Ingenieure, die an vorderster Front am Pretraining arbeiteten, fürchteten alle um ihre Jobs.
Kürzlich kursierten in der Branche Nachrichten, dass einige Unternehmen für verkörperte Intelligenz begonnen haben, Algorithmus-Stellen zu streichen.
Fähigkeiten, für deren Ausarbeitung früher eine große Menge an Daten, Rechenleistung und Algorithmus-Ingenieuren
Diandian
erforderlich waren, kann GPT-6 Astra in einigen Tests ohne zusätzliches Post-Training für spezifische Aufgaben demonstrieren.
Wie soll man da noch mithalten???
Ein Ingenieur, der bei einem Robotikunternehmen an der Modellentwicklung arbeitet, sagte gegenüber Quantum位:
Verglichen mit der Tatsache, dass die verkörperte Intelligenz noch keinen Durchbruch auf Paradigma-Ebene erlebt hat, treffen allgemeine große Modelle, wie sie durch Astra repräsentiert werden, die verkörperte Branche vertikal durch Coding. Das ist der eigentliche Schock.
Der durch den Schock verursachte Druck kommt nicht ausschließlich aus dem Silicon Valley.
Im Vergleich zum technologischen Fortschritt ausländischer Unternehmen für große Modelle wie OpenAI sind inländische Unternehmen für verkörperte Intelligenz empfindlicher gegenüber den nächsten Schritten lokaler Anbieter großer Modelle.
Kimi
,
DeepSeek
, Zhipu... Diese Namen werden zu Variablen, denen die verkörperte Branche Aufmerksamkeit schenken muss.
In der kürzlich populär gewordenen RoboDojo-Bewertung haben auch immer mehr Teams begonnen, zu versuchen, allgemeine große Modelle (wie GPT-6 Astra) in ihre eigenen Robotersysteme einzuführen, mit starker Generalisierung und erstaunlichen Fähigkeiten.
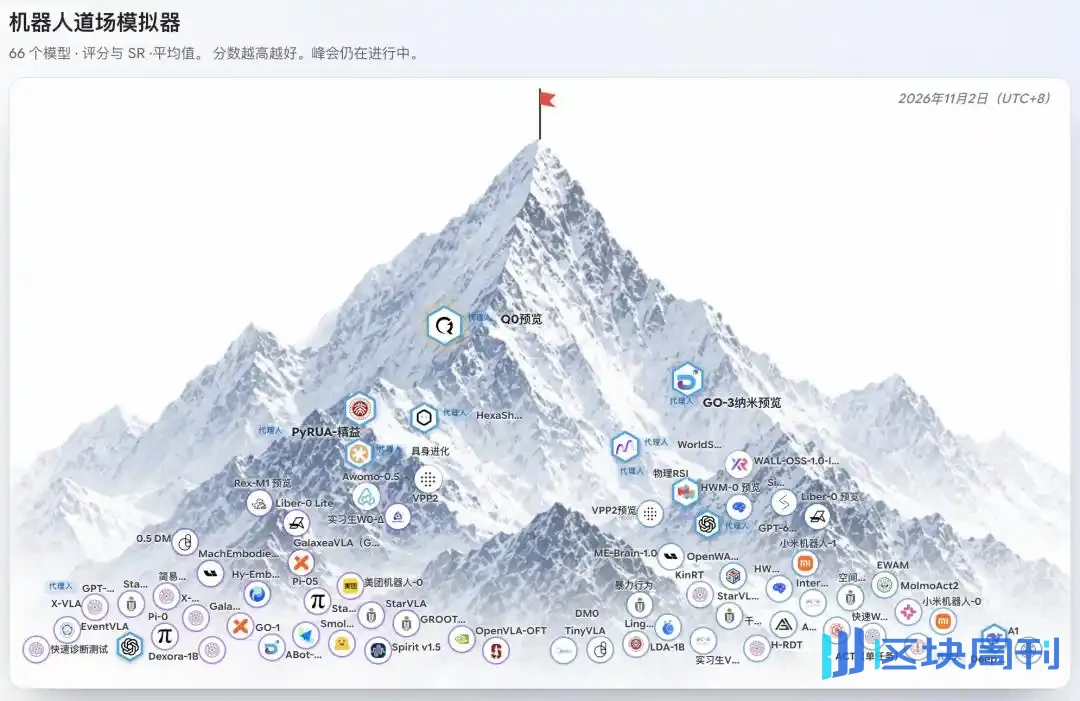
Laut Chen Tianxing, Erstautor des RoboTwin/RoboDojo-Bewertungsbenchmarks, beginnen nun auch einige Teams, die ursprünglich auf dem Training nativer verkörperter Fundamentmodelle beharrten, Lösungen einzureichen, die Technologien wie Robot-Use-Agent (RUA) kombinieren und allgemeine große Modelle nutzen, um Roboteraufgaben zu erledigen.
Der Effekt ist ziemlich direkt. Modelle, die ursprünglich nur 20 oder 30 Punkte erzielten, können nach der Kombination mit Astra-bezogenen Lösungen ihre Bewertungsergebnisse auf 50 oder 60 Punkte verbessern.
Die Punktzahlen in der Rangliste sind gestiegen, aber die Unternehmen für verkörperte Intelligenz haben nur einen Gedanken im Kopf:
Ist es überhaupt noch notwendig, Modelle im eigenen Haus zu entwickeln... (wein)

Als Doktorand in der Richtung embodied intelligence am MMLab der Universität Hongkong nahm Chen Tianxing an der Erstellung von RoboDojos Bewertungs- und Beurteilungsbericht über GPT-6 Astra (im Folgenden als „Bericht“ bezeichnet) teil.

△Der frühe Bewertungsbericht des RoboDojo-Teams über GPT-6 Astra
Als Chen Tianxing an einen Tag Mitte September zurückdachte, erzählte er Quantum位, dass er mehrere Sekunden lang wie erstarrt war, als seine Partner ihm nacheinander die Testergebnisse brachten:
Man kann sehen, dass seine Auswirkungen auf 3D-Rekonstruktion, Mathematik und verschiedene andere Bereiche beispiellos sind.
Beängstigend, wirklich ziemlich beängstigend.
Alle waren von GPT-6 verblüfft
„Embodied-Inhouse-Modelle fügen bei 80 Punkten immer noch 0,1 und 0,2 Punkte hinzu, während GPT-6 Astra bereits in einem Sprung von 80 Punkten auf 90 Punkte gestiegen ist.“
Dies ist ein anschaulicher Vergleich, den Chen Tianxing bei der Durchsicht dieser Bewertung anstellte.
Noch bemerkenswerter ist, dass Astra in einigen Tests nicht einmal zusätzliches Post-Training für spezifische Aufgaben durchlief und auch keine Aufgabendemonstrationen verwendete; allein auf der Grundlage von Sprachanweisungen war es in der Lage, eine ganze Reihe von Roboter-Manipulationsaufgaben zu bewältigen.
Am meisten überraschte ihn, dass Astra plötzlich drei Fähigkeiten zeigte, die embodied Modelle zuvor gezielt überwinden mussten.
Die erste ist ICL (In-Context Learning).
Einfach gesagt, ermöglicht es einem Roboter, eine neue Aufgabe durch eine kleine Menge kontextueller Informationen schnell zu erlernen.
Wenn beispielsweise ein Mensch ein Video von sich bei der Ausführung einer Operation aufnimmt und Textbeschreibungen hinzufügt, kann der Roboter verstehen, wie der Mensch es gemacht hat, und versuchen, den Roboterarm es nachahmen zu lassen.
Im Juli dieses Jahres war ICL in der Embodied-AI-Community noch eine recht populäre Forschungsrichtung. Das gängige Paradigma besteht darin, menschliche Operationen zu demonstrieren und den Roboter sie nachahmen zu lassen, um neue Fähigkeiten zu erwerben – das sogenannte One-Shot-In-Context-Learning.
Doch die Community stellte fest, dass die Bereitstellung von Bild- oder Textdemonstrationen für Astra zu einer höheren Erfolgsrate führen konnte als die Nichtbereitstellung von Demonstrationen.
Noch überraschender war seine Online-Anpassungsfähigkeit. Die Forscher änderten absichtlich die Kameraperspektive und das Aktionskoordinatensystem, und Astra war in der Lage, seine Strategie nach mehreren Versuchsrunden basierend auf den tatsächlichen Ausführungsergebnissen anzupassen und die Aufgabe erfolgreich abzuschließen.
Mit anderen Worten: Es kann nicht nur den Kontext verstehen, sondern sich auch während des Handelns selbst korrigieren.
Aus Chen Tianxings Sicht liegt dies daran, dass allgemeine Modelle selbst über starke kontextuelle Verständnisfähigkeiten verfügen. Während eines gewöhnlichen Chats kann es sich an den bisherigen Gesprächsverlauf erinnern; wenn man ihm ein Video gibt, kann es auch die Beziehung zwischen dem Videoinhalt und dem Text verstehen.
Die Übertragung dieser Fähigkeiten auf die Roboter-Manipulation bedeutet, dass das ICL-Problem, das ursprünglich dedizierte Forschung erforderte, plötzlich eine fertige Lösung hat.
Die zweite ist die OOD-Generalisation (Out-of-Distribution) und die Korrekturfähigkeit.
In realen Umgebungen geraten Roboter leicht in Situationen außerhalb ihrer Trainingsdaten.
Beispielsweise ist ein Roboterarm kurz davor, eine Tasse zu greifen, aber die Tasse wird plötzlich angestoßen und ihre Position verändert sich.
Ein Modell, das sich übermäßig auf Trainingsdaten verlässt, könnte weiterhin entlang der ursprünglichen Trajektorie ausführen und am Ende ins Leere greifen.
Astra kann seine Aktionen jedoch auf der Grundlage der veränderten visuellen Informationen neu anpassen und versuchen, das Objekt zu greifen.
Es klingt nach einer winzigen Aktion, aber dahinter steht die Frage, ob ein Roboter sich an die reale Welt anpassen kann.
Schließlich ist in der realen Welt niemand dafür verantwortlich, jede Tasse wieder an ihre Position während des Trainings zu stellen.
Die dritte ist die Open-Vocabulary-Manipulation.
Diese Fähigkeit umfasst die Abstimmung zwischen Sprache und Aktionen.
Wenn ein Nutzer beispielsweise eine Operationsanfrage auf unterschiedliche Weise formuliert, kann der Roboter sie dennoch verstehen und ausführen.
In der Vergangenheit gab es oft eine Diskrepanz zwischen Sprachverständnis und Aktionsausführung, und embodied Modelle benötigten ein Post-Training für spezifische Aufgaben, um die Abstimmung besser zu erreichen.
Doch Astra hat in dieser Hinsicht stärkere Fähigkeiten gezeigt. In einigen Tests konnte es selbst ohne zusätzliches Post-Training und Demonstrationen für spezifische Aufgaben eine ganze Reihe von Roboter-Manipulationsaufgaben allein auf der Grundlage von Sprachanweisungen abschließen.
Aus der Sicht von Chen Tianxing waren die oben genannten drei einst hochbedeutende technische Thesen im Bereich der embodied AI, und in der Vergangenheit hätte jede von ihnen als eigenständige Startup-Geschichte präsentiert werden können.
Nun hat Astra alle drei auf einmal gelöst, was einen nahezu explosiven Schock für die ursprüngliche F&E-Route der embodied Modelle darstellt.

△Zero-Shot-Testergebnisse auf dem RoboDojo-Sim-Benchmark bedeuten nicht, dass Astra diese Aufgaben bereits auf realen Robotern stabil abschließen kann.
Im Bericht merkte das RoboDojo-Team an, dass Astras Tests auf realen Maschinen einst aufgrund von Sicherheitsproblemen ausgesetzt wurden.
Hohe Punktzahlen auf einem Simulations-Leaderboard können noch nicht direkt mit Produktivität in der realen Welt gleichgesetzt werden.
Aber es reicht bereits aus, um embodied Unternehmen dazu zu bringen, ihre bisherigen F&E-Investitionen zu überdenken.
Warum kann ein allgemeines großes Modell, das ursprünglich nicht für Roboter-Manipulation entwickelt wurde, sich schnell Fähigkeiten nähern, die embodied Unternehmen über Jahre hinweg angesammelt haben?
Es ist gewissermaßen ein unbeabsichtigter Erfolg.
Obwohl allgemeine große Modelle nicht von Grund auf Robotik gelernt haben, betraten sie das Robotikfeld mit einer Reihe von Fähigkeiten, die während des groß angelegten Pretrainings angesammelt wurden, wie Sprache, Vision, Reasoning und Coding.
Diese Fähigkeiten hatten ursprünglich jeweils ihre eigenen Verwendungszwecke, aber unerwarteterweise lassen sie sich, wenn sie auf Roboter angewendet werden, auch direkt nutzbringend einsetzen.
Im Gegensatz dazu trainieren viele embodied Unternehmen Roboter-Gehirne von Grund auf, und die Daten, über die sie verfügen, stammen hauptsächlich aus der Roboter-Manipulation selbst.

Damit das Modell die Umgebung versteht, Anweisungen versteht und Aktionen lernt, müssen viele Fähigkeiten
Diandian
aus begrenzten Daten herausgearbeitet werden.
Das eine betritt die Robotik mit einem vollständigen Satz allgemeiner Fähigkeiten, während das andere noch immer Daten, Rechenleistung und Arbeitskraft getrennt für jede Fähigkeit investiert.
In diesem Wettbewerb sind die Startlinien selbst unterschiedlich.
Besteht noch Bedarf an selbst entwickelten Modellen?
GPT-6 Astra ist tatsächlich sehr stark, aber es ist noch nicht stark genug, um embodied Unternehmen einfach die Waffen strecken und kapitulieren zu lassen.
Zumindest in der realen physischen Welt warten noch viele harte Nüsse darauf, geknackt zu werden.
Xu Huazhe, Gründer von Pokebot, unterteilt die Fähigkeiten verkörperter Intelligenz in drei Ebenen: semantische, räumliche und physische Generalisierung.
Er ist der Ansicht, dass Astra bei den ersten beiden herausragend abschneidet, aber bei komplexem physischem Kontakt, Kraftänderungen, Objektverformung und hochpräziser Manipulation noch immer vor Herausforderungen steht.
Einem Roboter beispielsweise beizubringen, wo eine Tasse ist und dass er danach greifen soll, ist völlig anders, als ihn eine Tasse stabil greifen zu lassen.
Ist die Tasse weich oder hart? Wie viel Kraft sollte beim Greifen aufgewendet werden? Welche Veränderungen treten auf, nachdem das Objekt gedrückt oder gestoßen wurde?
Diese Probleme lassen sich nicht allein durch das Verstehen der visuellen Eindrücke und das Erfassen von Anweisungen lösen.

△Screenshot des Berichts
Das RoboDojo-Team stellte in seiner Bewertung außerdem fest, dass Astra nicht bei allen Aufgaben überlegen abschneidet.
Geometrische Ausrichtung und das Verstehen von Sprachbefehlen sind seine Stärken, aber wenn es um kontinuierlichen Kontakt und mehrstufige physische Manipulation geht, haben bestehende VLAs noch reichlich Verbesserungspotenzial.
Wang Qian, Gründer von X Square Robot, vertritt die Auffassung, dass allgemeine große Modelle, um in die verkörperte KI einzudringen, sich weiterhin mit Infrastrukturfragen wie Roboterdaten, Bewertung in der realen Welt, Hardware, Simulation und Deployment auseinandersetzen müssen.
Diese Schwierigkeiten werden nicht einfach dadurch verschwinden, dass man ein leistungsfähigeres Sprachmodell besitzt.
Die Frage ist, werden die Dinge, die Astra heute nicht gut kann, morgen plötzlich machbar sein?
Derzeit besteht ein weiterer häufiger Kritikpunkt an Astra in der Branche darin, dass seine Inferenzgeschwindigkeit zu langsam ist.

Chen Tianxing bemerkte ebenfalls, dass die GPT-6 Astra Cloud-API eine relativ hohe Inferenzlatenz aufweist, was ein echtes Hindernis für die Echtzeit-Regelung von Robotern im geschlossenen Regelkreis darstellt.
Man stelle sich vor: Wenn ein Roboter vor jeder Aktion darauf warten müsste, dass das große Modell lange nachdenkt, wäre es wohl schwer, die Anforderungen realer Szenarien zu erfüllen.
Doch Chen Tianxing ist der Ansicht, dass dieses Problem keine grundsätzliche Barriere darstellt; es gibt bereits viele bestehende Lösungen für das On-Device-Deployment von LLMs, einschließlich Technologien wie Modellquantisierung, Destillation und On-Device-Inferenz-Engines. Solange große Modellunternehmen die Robotik als wichtiges kommerzielles Szenario betrachten, können sie mit dem vorhandenen Technologie-Stack die Latenzoptimierung abschließen.
Hinter diesem Problem verbirgt sich ein sehr leicht zu verwechselndes Konzept: „Modell-Inferenzfrequenz“ und „Roboter-Steuerungsfrequenz“ sind nicht dasselbe.
Ein verkörperter Modell-Ingenieur, der anonym bleiben wollte, sagte gegenüber QbitAI:
Langsame Inferenz kann dennoch eine schnelle Steuerung ermöglichen; geopfert wird lediglich die Reaktionsgeschwindigkeit. Für Fließbandaufgaben, die stärker rhythmusabhängig sind, ist dies tatsächlich irrelevant.
Beispielsweise müssen Roboter bei der Sortierung von Expresspaketen kontinuierlich und stabil greifen und ablegen. Das übergeordnete Modell ist dafür verantwortlich, die Aufgabe zu verstehen und Aktionen zu planen, während das untergeordnete Steuerungssystem Steuerbefehle mit höherer Frequenz ausführt.
Solange die Aufgabe eine Vorausplanung erlaubt oder eine gewisse Toleranz gegenüber Reaktionslatenz aufweist, muss das große Modell nicht unbedingt an jedem untergeordneten Steuerungszyklus teilnehmen.
Natürlich ist die Reaktionsgeschwindigkeit bei Aufgaben mit schnellen dynamischen Veränderungen und komplexem Kontakt nach wie vor wichtig.
Aber zumindest bedeutet langsame Inferenz nicht unbedingt, dass die Steuerung des Roboters nicht schnell ist.

Die verschiedenen Mängel, die die heutigen allgemeinen großen Modelle offenbaren, können nicht direkt als der Burggraben betrachtet werden, auf den sich verkörperte Unternehmen in Zukunft zum Überleben verlassen werden.
Für verkörperte Unternehmen ist diese Wahrheit etwas schmerzhaft zu hören.
Aber die Fakten liegen auf der Hand. In diesem Jahr hat OpenAI bereits begonnen, eine große Anzahl von robotikbezogenen Stellen zu rekrutieren.
Wenn allgemeine Modelle in Zukunft mehr Daten zur Robotermanipulation aufnehmen, könnten die Fähigkeitsgrenzen, die ursprünglich zu spezialisierten verkörperten Modellen gehörten, weiter komprimiert werden.
Haben verkörperte Unternehmen noch Chancen? Ist eine Eigenentwicklung von Modellen noch notwendig?
Chen Tianxings Urteil lautet, dass die Chance für verkörperte Unternehmen nicht darin liegt, wessen Modell intelligenter ist, sondern darin, wer einen besseren „wirtschaftlichen Nutzen“ erzielen kann.
Diese Rechnung ist leicht zu kalkulieren.
An einer hochgradig standardisierten industriellen Montagelinie, an der Roboter jeden Tag dieselben Aktionen wiederholen, interessieren sich Kunden am meisten für Erfolgsquote, Zykluszeit, Stabilität und Kosten.
Wenn es ein paar Cent kostet, ein Modell aufzurufen, das die Aufgabe stabil erledigen kann, warum sollte man dann darauf bestehen, ein paar Dollar auszugeben, um GPT-6 Astra aufzurufen?
Selbst wenn ein gewisses Maß an Intelligenz und Generalisierungsfähigkeit erforderlich ist, kann ein speziell optimiertes kleines Modell wirtschaftlicher sein als der direkte Aufruf von Astra.

Natürlich ist die Situation anders, wenn es sich um einen Haushaltsdienstroboter handelt.
Heute räumt er den Tisch auf, morgen sucht er Gegenstände, und übermorgen kommt eine neue Aufgabe, die er noch nie gesehen hat.
In einer solchen offenen Umgebung gilt: Je vielfältiger die Aufgaben, desto höher die Anforderungen an Verständnis, Planung und Generalisierungsfähigkeit. Ein stärkeres allgemeines Modell kann stattdessen mehr Vorteile haben.
Am 6. November erklärte Chen Tianxing den Unterschied in seinem persönlichen Blog anhand von zwei Achsen.
Die linke Seite sind die „Szenarioanforderungen“, die rechte Seite sind die „Modellfähigkeiten“. Je weiter oben, desto mehr Betonung auf Allgemeinheit; je weiter unten, desto mehr Betonung auf Effizienz.

△Chen Tianxings Blog
„Offene Aufgaben können sich stärker auf allgemeine Modelle verlassen, stabile Aufgaben können Regeln oder leichtgewichtige Strategien übernehmen, und die Szenarien dazwischen lassen Raum für szenariooptimierte Modelle“, sagte Chen Tianxing.
Meiner Ansicht nach läuft das Zusammenbringen der beiden Achsen auf einen Satz hinaus:
Wenn etwas mit Regeln/leichtgewichtigen Strategien gelöst werden kann, muss kein großes Modell herangezogen werden; wenn eine Aufgabe mit einem kleinen Modell erledigt werden kann, muss nicht jedes Mal Astra aufgerufen werden.
Umgekehrt gilt: Wenn die Aufgaben zu stark variieren, müssen spezialisierte Modelle kontinuierlich Daten sammeln und neu trainieren, sodass der direkte Aufruf eines allgemeinen Modells möglicherweise kosteneffizienter ist.
Die Entscheidung, welchen Ansatz man wählt, erfordert letztlich die Berechnung einer vollständigen wirtschaftlichen Rechnung.
Wie hoch ist die Erfolgsquote einer einzelnen Aufgabe? Wie viel Zeit nimmt sie in Anspruch? Wie viel manueller Eingriff ist nach einem Fehlschlag erforderlich? Wie viel kosten Datenerfassung, Modelltraining und langfristiger Betrieb?
Diese konkreten Zahlen bestimmen, ob ein Robotersystem kommerziellen Wert hat.
Also, ist es nicht so, dass die Eigenentwicklung unwichtig ist, sondern dass die „Eigenentwicklungsrichtungen“ von Embodied-Unternehmen neu geordnet werden müssen.
Fähigkeiten, in denen allgemeine Modelle bereits gut sind, wie Sprachverständnis und Aufgabenplanung, können für eine direkte Nutzung in Betracht gezogen werden; Fragen, die physische Interaktion, spezifische Körpersteuerung, Anpassung an reale Szenarien und Effizienz der Bereitstellung betreffen, erfordern weiterhin umfangreiche spezialisierte Forschung und Entwicklung.
Was die Frage betrifft, ob es notwendig ist, weiterhin ein größeres Embodied-Fundamentmodell von Grund auf zu trainieren, hängt es davon ab, ob es in tatsächlichen Aufgaben ausreichend offensichtliche und ausreichend dauerhafte Vorteile bieten kann.
Einige Branchenfreunde beschwerten sich bei Quantum位, dass viele Embodied-Teams noch immer eine ziemlich starke akademische Denkweise mit sich tragen und ständig darüber nachdenken, ein allgemeines Intelligenzmodell zu bauen, und am liebsten alle Aufgaben in ihr eigenes Modell stopfen würden.
Aber die Lage hat sich inzwischen geändert. GPT-6.2 Astra steht kurz bevor.
Wenn die Forschungsrichtung eines Unternehmens von seiner Zielbranche entkoppelt ist, mag das Modell noch so schön trainiert sein, der kommerzielle Kreislauf muss trotzdem nicht unbedingt halten.
Noch eine Sache
In den vergangenen 60 Tagen sind viele Praktiker der Embodied-Branche, wenn sie sich privat unterhalten, noch immer verwirrt.
Nur in der Öffentlichkeit, wenn es darum geht, ihre eigenen Interessen und Positionen zu verteidigen, müssen sie trotzdem bis zum Ende standhalten.
Sicher ist, dass GPT-6 Astra tatsächlich den ursprünglichen Rhythmus der Embodied-Branche durcheinandergebracht hat...
Der Matthäus-Effekt, die Neubewertung der Branche nach dem Börsengang von Unitree, RSI als neuer Hotspot... alles zusammen genommen hat schließlich die jüngste Branchenstimmung geformt –
„Investoren beginnen, nicht mehr in Embodied AI zu investieren.“
Das mag etwas übertrieben sein, aber es ist vollkommen wahr, dass Start-ups für embodied intelligente Roboter sich von der Demo- und Investitionsverbrennungsphase verabschieden.
Die Ausscheidungsrunde der Hundert-Maschinen-Schlacht hat bereits begonnen.
Dieser Artikel stammt vom WeChat-öffentlichen Account „Quantum位“ (ID: QbitAI), Autor: Fokus auf Frontier-Technologie