
Около 90% собственного кода Claude Code уже передано Claude для написания.
Теперь, когда код пишет ИИ, количество изменений соответственно резко возросло: с июня по сентябрь количество PR, слитых в кодовую базу, более чем удвоилось.
Во всей Anthropic количество изменений, ежедневно сливаемых в основную кодовую базу, выросло примерно с 2500 в мае до более чем 30 000 в сентябре.
При таком объёме кода успевают ли люди его читать? И если даже проверку передать ИИ, кто судит, ошибся ли он?
15 октября команда Claude Code публично раскрыла свой внутренний процесс проверки кода, сообщив, что, хотя количество PR удвоилось, доля PR, требующих отката, фактически снизилась относительно этого более чем на 40%.
Они добились этого с помощью шести уровней проверок плюс механизма отката для быстрого обнаружения и быстрого отката.
Суждение команды Claude Code таково:
При таком масштабе построчная проверка людьми больше не реалистична.
Но они не отменили проверку; вместо этого они передали большую часть работы по чтению кода машинам.
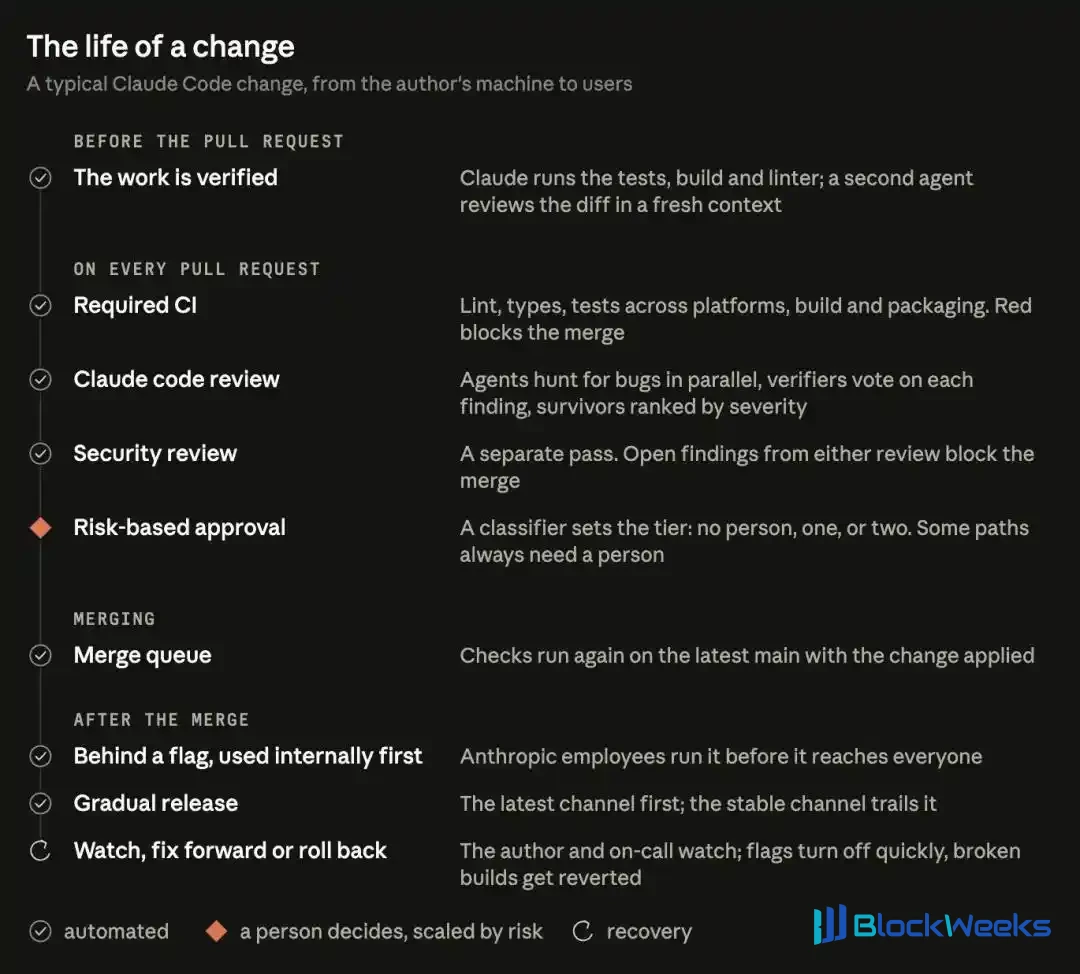
Прежде чем фрагмент кода, написанного ИИ, будет запущен, он должен сначала пройти тесты, пройти проверку ИИ и проверку безопасности, а затем, исходя из риска, принимается решение о том, нужно ли одобрение человека.
По мнению команды Claude Code, вопрос «читал ли кто-нибудь этот код» недостаточно точен.
Настоящий вопрос должен быть таким:
Что может пойти не так с этим изменением, и если что-то пойдёт не так, какая проверка должна это остановить?
До проверки человеком , ИИ сначала представляет результаты проверки
Одно изменение должно пройти шесть проверок, а в конце — страховочная сеть.
Первые ворота — до создания запроса на слияние (PR).
Claude должен запустить тесты и завершить сборку; для изменений, затрагивающих интерфейс, он также должен сделать скриншоты для сравнения с дизайн-макетами.
Затем запускается субагент со свежим контекстом для проверки диффа кода; он не участвовал в написании кода и предназначен исключительно для поиска ошибок.
Официальное требование очень чёткое:
Claude должен представить выполненные команды и их вывод; просто ответ «все тесты пройдены» не считается.
Обычные разработчики могут последовать этому примеру: давая ИИ задачу, чётко указывайте также, как будет проверяться приёмка.
Вторые ворота — это проверка ИИ в PR.
Несколько агентов параллельно ищут ошибки, а другая группа голосованием проверяет. Только когда набрано достаточно голосов, проблема публикуется в PR.
Комментарии, касающиеся только стиля кода, диагностических подсказок или очистки кода, не будут публиковаться в PR и отфильтровываются напрямую.
Когда эта система рецензирования впервые была запущена в марте, доля внутренних PR, получающих содержательные комментарии по рецензированию, выросла с 16% до 54%.
Третий этап — проверка безопасности.
Внутри команды, пока замечания, оставленные при рецензировании кода или проверке безопасности, остаются неразрешёнными, PR не может быть объединён: либо исправьте их, либо закройте с письменным обоснованием.
Четвёртый этап — проверки непрерывной интеграции (CI), включая стандарты кода, проверку типов, платформенные тесты и сборку пакетов.
Одно обычное изменение инструмента командной строки (CLI) может пройти десятки проверок, прежде чем будет передано на проверку человеку.
Повторяющиеся проблемы также должны становиться основой для следующего раунда проверок.
CLAUDE.md фиксирует соглашения проекта, а REVIEW.md указывает рецензенту, на что обращать внимание и что можно пропустить, чтобы проблемы, найденные на этот раз, становились опытом для следующего рецензирования.
Когда один и тот же комментарий упоминается в третий раз, его следует записать в правила.
Пятый этап — одобрение человеком, и он наиболее критичен; мы подробно обсудим его в следующем разделе.
Шестой этап — объединение и выпуск.
После того как изменение проходит предыдущие этапы, оно всё равно должно попасть в очередь на объединение и дождаться своей очереди.
Когда подходит его очередь, система помещает его на последнюю версию основной ветки, и все проверки запускаются снова.
Этот шаг защищает от ситуации «каждая часть по отдельности в порядке, но при объединении возникают проблемы».
После объединения новые функции также не сразу становятся доступны всем пользователям.
Сначала они скрыты за функциональными флагами и открыты только для внутренних сотрудников Anthropic. Сотрудники интенсивно используют их каждый день и часто сталкиваются с проблемами раньше внешних пользователей.
А функциональный флаг подобен главному выключателю: без изменения кода или повторного выпуска версии он может решить, включена функция или выключена.
И наконец, есть запасной вариант.
Если возникает проблема, сначала дёрните главный выключатель.
Команда по очереди дежурит каждую неделю, и каждый разбор инцидента должен задавать вопрос: на каком этапе это должно было быть остановлено?
Итак, рецензирование не исчезло — оно превратилось в слой за слоем проверок, проходящих через разработку, объединение и выпуск.
Где проходят границы одобрения без участия человека
После того как первые четыре этапа все пройдены, пятый этап решает на основе градации риска, сколько человек должны одобрить это изменение.
Документация, текст, функции, видимые только внутри, и новые изменения, скрытые за флагами, относятся к низкому риску; как только автоматическое рецензирование и проверки безопасности пройдены, они могут пропустить одобрение человеком.
Обычные продуктовые изменения, а также чувствительные области, такие как кэширование, автообновление и системные промпты, требуют одного человека.
Код наивысшего риска, а также несколько designated путей, требуют двух человек.
На первый взгляд, изменения низкого риска уже «без водителя»?
Не всё так просто.
Уровень риска определяется самим изменением: первый классификатор читает код и устанавливает риск, а второй затем решает, нужно ли дополнительное одобрение человеком.
Чувствительные пути, отмеченные владельцами кода, а также все файлы рабочих процессов CI должны быть проверены человеком.
У облегчённого канала одобрения также есть порог: он открыт только для людей из списка «доверенных авторов» репозитория; любой, кто не входит в список, должен найти другого человека для одобрения.
Человек, направляющий ИИ писать код, сам считается рецензентом и должен нести ответственность за изменение так же, как если бы он написал код вручную.
Одобрение без участия человека не означает отсутствие ответственности.
Люди должны решать, следует ли создавать функцию, разумна ли архитектура и могут ли существующие проверки покрыть риск этого изменения.
Итак, у команды Claude Code есть правило: код, который вы вливаете, — если что-то пойдёт не так, обычно исправляете вы.
Прежде чем нажать «одобрить», рецензент должен уметь чётко объяснить: что именно проверили эти проверки и какие риски остались непокрытыми.
Если вы не можете это объяснить, не спешите нажимать «одобрить» — сначала добавьте необходимую проверку.
ИИ-ревью тоже может давать сбои
Автоматическое ревью тоже может застрять.
PR для проекта CLI за ночь прошёл более пятидесяти раундов ревью и исправлений, пока автор наконец не остановил его вручную.
Человек может за секунду проигнорировать мелкую проблему, а ИИ не станет — он добросовестно пойдёт её исправлять, а после исправления появится ещё один коммит и ещё один раунд ревью.
Команда с помощью git blame проследила историю и обнаружила, что из проблем, которые рецензент раз за разом отмечал, около 59% были старым кодом, существовавшим ещё до первого раунда ревью. Новые баги он находил редко; каждый раунд он просто выкапывал ещё несколько старых.
Позже они изменили четыре правила:
Если после трёх раундов всё ещё не пройдено, напомнить автору отступить и переосмыслить подход;
После первых нескольких раундов проверять только вновь добавленные изменения;
Указывать проблемы одного и того же типа сразу все;
Не повторять проблемы, которые уже были подняты.
Эффект был мгновенным.
Доля внутренних PR, проходивших после одного раунда ревью и исправлений, выросла с 65% до 78%; нуждавшихся в пяти и более раундах — упала с 8,9% до 1,5%; среднее число ревью снизилось с 2,08 до 1,32.

После корректировки правил повторного ревью доля прохождений после одного раунда ревью и исправлений выросла с 65% до 78%, а среднее число ревью снизилось с 2,08 до 1,32.
Искусство ревью наполовину состоит в том, чтобы находить проблемы, а наполовину — в том, чтобы знать, когда остановиться.
Означает ли многоуровневое ревью, что оно безотказно?
Сама Anthropic привела контрпример.
26 марта Claude Code выпустил оптимизацию: когда сессия простаивает более часа, один раз очищать старые записи рассуждений.
Но из-за бага очистка запускалась на каждом шаге после возобновления разговора. В результате Claude стал забывчивым, начал повторяться и аномально использовать инструменты. Баг исправили только 10 апреля.

После простоя старые рассуждения должны были очищаться только один раз, но на самом деле очистка продолжалась на каждом шаге; красная рамка отмечает ошибочно удалённое содержимое.
Официальный разбор инцидента 23 апреля признал:
Это изменение прошло через несколько раундов человеческого и автоматического ревью; модульные тесты, сквозные тесты и внутреннее догфудинг не смогли его поймать, и только на подтверждение первопричины ушло больше недели.
Переломный момент наступил в ходе разбора инцидента.
Команда заново проверила PR, вызвавший инцидент, с помощью Code Review; при достаточном контексте из соответствующих репозиториев Opus 4.7 нашёл баг, а Opus 4.6 — нет.
Этот бэктест показал, что и возможности модели, и полнота контекста влияют на результаты обнаружения. Поэтому они включили в ревью подтягивание большего числа репозиториев.
Сегодня каждый инцидент становится экзаменационным вопросом.
Команда собирает PR, инженеры, знакомые с кодом, подтверждают ошибки в них одну за другой и составляют из них тестовый набор.
Ревьюер ежедневно прогоняется по этому тестовому набору. Каждый раз, когда корректируются промпты, инструменты или модели, он также используется для проверки эффекта: если оценка не улучшается, корректировка не принимается.
Команда также не преувеличивала.
После выхода изменений в продакшн разработчикам и дежурным сотрудникам по-прежнему нужно выявлять аномалии с помощью дашбордов с данными.
Механизм «предохранителя», который автоматически ужесточает согласования на основе таких метрик, как частота откатов, ещё не построен. Инженеры хотят сначала добавить эту защитную меру, прежде чем пропускать больше изменений через одобрение без участия человека.
Ревью неизбежно что-то упустит; обнаружение и устранение проблем тоже должны успевать.
Один из членов команды Claude Code объяснил это так: замедление действительно снижает количество ошибок, но в основном потому, что вы делаете меньше всего. Поэтому они предпочитают тратить усилия на то, чтобы быстрее находить проблемы и быстрее их исправлять.
Когда один человек пишет код с помощью ИИ, что нужно принять
ИИ-ревью только даёт мнения; решение по-прежнему принимаете вы.
Поэтому не спешите стремиться к «не нужно смотреть» — вместо этого сначала заставьте ИИ отвечать на три вопроса при каждой поставке.
Во-первых, как это было проверено?
Какие проверки были запущены, каковы результаты и какие случаи ещё не покрыты.
Борис Черный, создатель Claude Code, говорил, что дать Claude способ проверять себя, возможно, самое важное. Он оценивает, что это может повысить качество конечного результата в 2–3 раза по сравнению с исходным.

Борис Черный рекомендует позволять Claude проверять собственную работу, чтобы сформировать цикл обратной связи; он оценивает, что качество конечного результата можно повысить в 2–3 раза.
Во-вторых, на что это повлияет?
Какие пользователи, данные и разрешения затронуты изменением.
Если вы поручаете ИИ добавить в инструмент отчётности функцию общего доступа, нужно чётко спросить: кто может открыть ссылку и что можно увидеть после её открытия.
В-третьих, как откатиться, если что-то пойдёт не так? Можно ли отключить новую функцию одним щелчком и вернуться к предыдущей версии.
Зафиксируйте архив перед началом и делайте каждое изменение как можно меньше. Сначала обеспечьте возможность отката, потом говорите о том, чтобы меньше ревьюить.
Помимо этих трёх вопросов, выработайте ещё три привычки.
Во-первых, проводите ревью другим «мозгом».
В сессии, где пишется код, легче всего закрыть глаза на собственные ошибки.
Откройте новую сессию или поручите субагенту провести ревью с совершенно свежим контекстом; локальные команды /code-review и /security-review также можно запускать напрямую.
Во-вторых, классифицируйте изменения по уровням.
Изменения текстов и стилей сливайте после прохождения проверок и подтверждения фактического эффекта; для всего, что связано с входом в систему, оплатой или удалением данных, человек должен тщательно проверить ключевую логику и добавить целевые тесты.
Сначала будьте строже, а когда процессы проверки и отката наладятся, постепенно сокращайте ручное ревью низкорисковых изменений.
В-третьих, если три раунда не дали результата, смените подход.
Если ИИ внёс правки за три раунда и всё ещё ходит по кругу, не заставляйте его делать четвёртый — сначала спросите, не ошибочен ли сам подход.
Самое важное: то, что ИИ сказал «прошло», не означает, что вы завершили приёмку.
Вы поручили ему написать код, и вы также должны нести ответственность за результаты после его выхода в продакшн.
Цель команды Claude Code — добиться того, чтобы большинство PR затрагивали не более одного человека, при этом удерживая показатель откатов и показатель инцидентов под контролем.
Человеческое внимание следует уделять в большей степени оценке рисков, подтверждению достаточности проверок и тому, как исправлять ситуацию после возникновения ошибок.
Людям не обязательно читать каждую строку кода, но за каждый релиз должен кто-то нести ответственность.
Источники:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Редактор: Yuanyu
Эта статья взята из публичного аккаунта WeChat «Xinzhiyuan» (ID: AI_era), автор: ASI Revelation