
Cerca de 90% do próprio código do Claude Code já foi entregue ao Claude para escrever.
Com a IA agora escrevendo o código, o número de alterações aumentou proporcionalmente: de junho a setembro, o número de PRs mesclados ao repositório de código mais que dobrou.
Em toda a Anthropic, as alterações mescladas ao repositório principal a cada dia subiram de cerca de 2.500 em maio para mais de 30.000 em setembro.
Com tanto código, os humanos ainda conseguem acompanhar a leitura? E se até a revisão for entregue à IA, quem julga se ela cometeu um erro?
Em 15 de outubro, a equipe do Claude Code divulgou publicamente seu processo interno de revisão de código, revelando que, embora o número de PRs tenha dobrado, a proporção de PRs que exigiam reversão na verdade caiu mais de 40% em relação a isso.
Eles conseguiram isso por meio de seis camadas de verificação, além de um mecanismo de fallback para detecção rápida e reversão rápida.
O julgamento da equipe do Claude Code é:
Nessa escala, a revisão humana linha por linha já não é realista.
Mas eles não aboliram a revisão; em vez disso, entregaram a maior parte do trabalho de ler o código às máquinas.
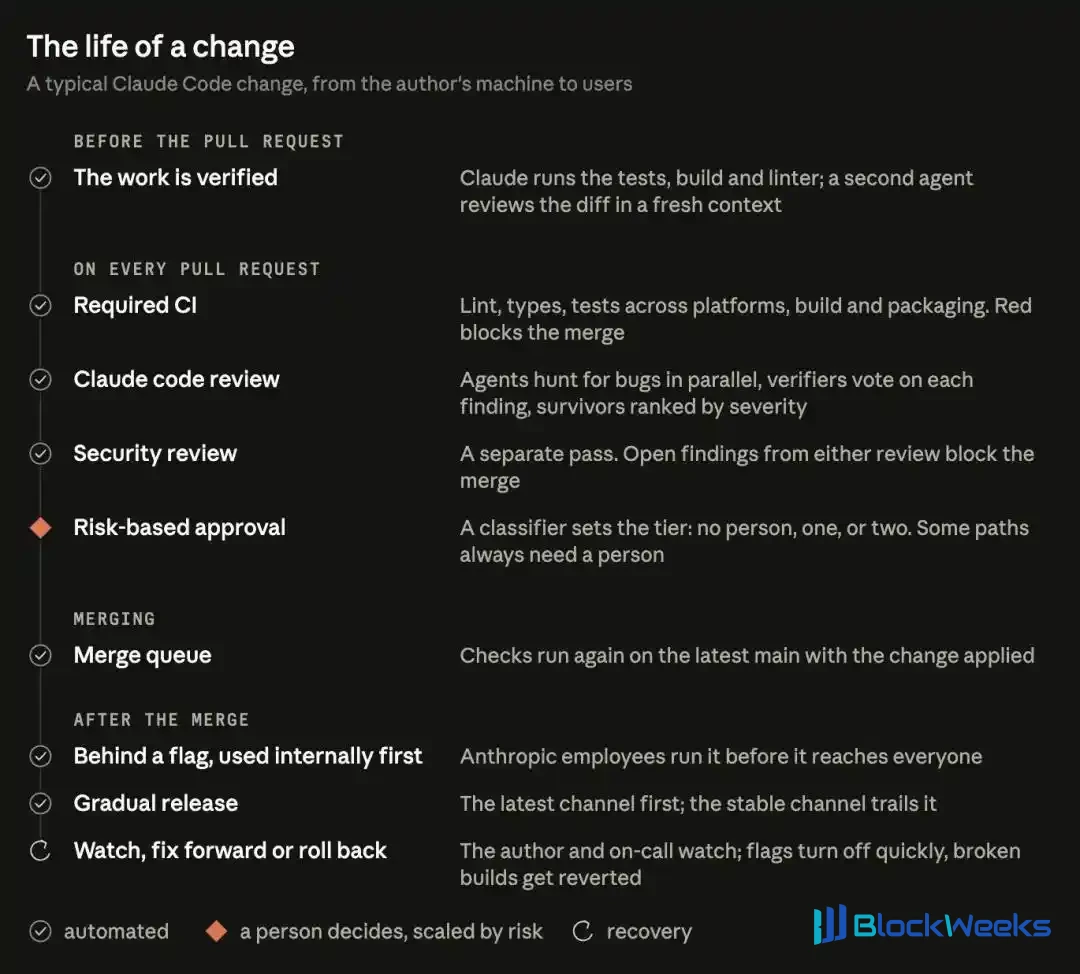
Antes que um trecho de código escrito por IA entre em produção, ele deve primeiro passar por testes, ser submetido à revisão de IA e de segurança e, então, com base no risco, decide-se se é necessária aprovação humana.
Na visão da equipe do Claude Code, "alguém leu este código" não é uma pergunta suficientemente precisa.
A verdadeira pergunta deveria ser:
O que pode dar errado com esta alteração e, se der errado, qual verificação deve impedi-la?
Antes da revisão humana , a IA primeiro apresenta os resultados da verificação
Uma única alteração deve passar por seis verificações, com uma rede de segurança no final.
O primeiro portão vem antes da criação de uma solicitação de merge (PR).
O Claude deve executar os testes e concluir a build; para alterações que envolvem a interface, ele também deve tirar capturas de tela para comparar com os mockups de design.
Em seguida, um subagente usando um contexto novo é despachado para revisar o diff do código; ele não participou da escrita do código e é dedicado a encontrar falhas.
A exigência oficial é muito clara:
O Claude deve apresentar os comandos executados e sua saída; apenas responder "todos os testes passaram" não conta.
Desenvolvedores comuns podem fazer o mesmo: ao dar uma tarefa à IA, declare claramente também como a aceitação será verificada.
O segundo portão é a revisão por IA no PR.
Vários agentes procuram bugs em paralelo, e outro grupo vota para verificar. Somente quando votos suficientes forem alcançados o problema será publicado no PR.
Comentários relativos apenas ao estilo de código, dicas de diagnóstico ou limpeza de código não serão publicados no PR e são filtrados diretamente.
Quando este sistema de revisão foi lançado pela primeira vez em março, a proporção de PRs internos que recebiam comentários de revisão substantivos subiu de 16% para 54%.
O terceiro portão é a revisão de segurança.
Dentro da equipe, enquanto os achados deixados pela revisão de código ou pela revisão de segurança permanecerem sem resolução, o PR não pode ser mesclado: ou eles são corrigidos, ou são encerrados com uma justificativa por escrito.
O quarto portão são as verificações de integração contínua (CI), incluindo padrões de código, verificação de tipos, testes de plataforma e empacotamento de build.
Uma única alteração comum em uma ferramenta de linha de comando (CLI) pode ter que executar dezenas de verificações antes de ser entregue para revisão humana.
Problemas recorrentes também devem se tornar a base para a próxima rodada de verificações.
O CLAUDE.md registra as convenções do projeto, e o REVIEW.md diz ao revisor no que focar e o que pode ser ignorado, para que os problemas encontrados desta vez se tornem experiência para a próxima revisão.
Quando o mesmo comentário é mencionado pela terceira vez, ele deve ser escrito nas regras.
O quinto portão é a aprovação humana, que é o mais crítico; vamos discuti-lo em detalhes na próxima seção.
O sexto portão é a mesclagem e a liberação.
Depois que uma alteração passa pelos portões anteriores, ela ainda precisa entrar na fila de mesclagem e esperar sua vez.
Quando chega sua vez, o sistema a coloca na versão mais recente do branch principal, e todas as verificações são executadas novamente.
Esta etapa protege contra "cada parte está bem isoladamente, mas surgem problemas quando combinadas".
Após a mesclagem, os novos recursos também não são imediatamente enviados a todos os usuários.
Eles são primeiro ocultados atrás de feature flags e abertos apenas para os funcionários internos da Anthropic. Os funcionários os usam intensamente todos os dias e frequentemente encontram problemas antes dos usuários externos.
E a feature flag é como um interruptor mestre: sem alterar o código ou relançar uma versão, ela pode decidir se um recurso está ativado ou desativado.
Por fim, há o fallback.
Se ocorrer um problema, acione primeiro o interruptor mestre.
A equipe faz rodízio de plantão semanalmente, e toda postmortem de incidente deve perguntar: em qual portão isso deveria ter sido barrado?
Portanto, a revisão não desapareceu—ela se tornou camada sobre camada de verificações percorrendo o desenvolvimento, a mesclagem e a liberação.
Onde estão os limites da aprovação zero-humana
Depois que os quatro primeiros portões estão todos verdes, o quinto portão decide, com base na classificação de risco, quantas pessoas precisam aprovar esta alteração.
Documentação, textos, recursos visíveis apenas internamente e novas alterações ocultas atrás de flags são de baixo risco; uma vez que a revisão automatizada e as verificações de segurança passam, elas podem pular a aprovação humana.
Alterações comuns de produto, bem como áreas sensíveis como cache, o atualizador automático e prompts de sistema, precisam de uma pessoa.
O código de maior risco, além de um punhado de caminhos designados, precisa de duas pessoas.
À primeira vista, as alterações de baixo risco já são "sem motorista"?
Não é tão simples.
O nível de risco é determinado pela própria alteração: o primeiro classificador lê o código e define o risco, e o segundo então decide se é necessária aprovação humana adicional.
Caminhos sensíveis marcados pelos code owners, bem como todos os arquivos de workflow de CI, devem ser revisados por uma pessoa.
O canal de aprovação leve também tem um limiar: ele é aberto apenas para pessoas na lista de "autores confiáveis" do repositório; qualquer pessoa fora da lista deve encontrar outra pessoa para aprovar.
A pessoa que orienta a IA a escrever código conta como revisora ela mesma, e deve assumir a responsabilidade pela alteração exatamente como se tivesse escrito o código à mão.
Aprovação zero-humana não significa que ninguém é responsável.
Os humanos devem decidir se um recurso deve ser construído, se a arquitetura é razoável e se as verificações existentes conseguem cobrir o risco desta alteração.
Então a equipe do Claude Code tem uma regra: o código que você faz merge — se algo der errado, geralmente é você quem conserta.
Antes de clicar em aprovar, o revisor precisa conseguir explicar claramente: o que essas verificações validaram e quais riscos permanecem descobertos.
Se você não consegue explicar, não se apresse em clicar em aprovar — primeiro adicione a revisão necessária.
A revisão por IA também pode falhar
A revisão automatizada também pode ficar travada.
Um PR de um projeto de CLI passou por mais de cinquenta rodadas de revisão e correções durante a noite, até que o autor finalmente interrompeu manualmente.
Um humano consegue ignorar um problema menor em um segundo, mas a IA não — ela vai diligentemente corrigi-lo, e depois de corrigir há outro commit, e outra rodada de revisão.
A equipe usou git blame para rastrear e descobriu que, dos problemas que o revisor sinalizava repetidamente, cerca de 59% eram código antigo que já existia antes da primeira rodada de revisão. Raramente encontrava novos bugs; a cada rodada apenas desenterrava mais alguns antigos.
Depois eles mudaram quatro regras:
Se ainda não passou após três rodadas, lembre o autor de dar um passo atrás e repensar a abordagem;
Após as primeiras rodadas, revisar apenas as alterações recém-adicionadas;
Apontar problemas do mesmo tipo de uma vez só;
Não repetir problemas que já foram levantados.
O efeito foi imediato.
A proporção de PRs internos que passaram após uma rodada de revisão e correções subiu de 65% para 78%; os que precisavam de cinco ou mais rodadas caíram de 8,9% para 1,5%; o número médio de revisões caiu de 2,08 para 1,32.

Após ajustar as regras de re-revisão, a taxa de aprovação após uma rodada de revisão e correções subiu de 65% para 78%, e o número médio de revisões caiu de 2,08 para 1,32.
A habilidade da revisão é metade sobre encontrar problemas e metade sobre saber quando parar.
Revisão em várias camadas significa que é à prova de falhas?
A própria Anthropic deu um contraexemplo.
Em 26 de março, o Claude Code lançou uma otimização: quando uma sessão fica ociosa por mais de uma hora, limpar uma vez os registros antigos de raciocínio.
Mas um bug fez com que ele executasse a limpeza a cada turno após uma conversa ser retomada. Como resultado, o Claude ficou esquecido, começou a se repetir e usou ferramentas de forma anormal. O bug só foi corrigido em 10 de abril.

Após ficar ocioso, o raciocínio antigo deveria ter sido limpo apenas uma vez, mas na verdade ele continuava limpando a cada turno; a caixa vermelha marca o conteúdo excluído por engano.
A postmortem oficial em 23 de abril admitiu:
Essa mudança passou por várias rodadas de revisão humana e automatizada; testes unitários, testes de ponta a ponta e dogfooding interno não conseguiram detectá-la, e só confirmar a causa raiz levou mais de uma semana.
O ponto de virada veio na postmortem.
A equipe revisou novamente com o Code Review o PR que causou o incidente; quando recebeu contexto suficiente dos repositórios relevantes, o Opus 4.7 encontrou o bug, enquanto o Opus 4.6 não.
Esse backtest mostrou que tanto a capacidade do modelo quanto a completude do contexto afetam os resultados de detecção. Então eles habilitaram a revisão para puxar mais repositórios.
Hoje, todo incidente se torna uma questão de prova.
A equipe coleta PRs, tem engenheiros familiarizados com o código confirmar os bugs neles um por um e os compila em um conjunto de testes.
O revisor é executado contra esse conjunto de testes todos os dias. Sempre que prompts, ferramentas ou modelos são ajustados, ele também é usado para verificar o efeito: se a pontuação não melhorar, o ajuste não é adotado.
A equipe também não exagerou nas coisas.
Depois que as mudanças entram no ar, desenvolvedores e plantonistas ainda precisam identificar anomalias usando painéis de dados.
O mecanismo de "disjuntor" que aperta automaticamente as aprovações com base em métricas como taxa de reversão ainda não foi construído. Os engenheiros querem adicionar essa salvaguarda primeiro antes de deixar mais mudanças passarem pela aprovação sem intervenção humana.
A revisão inevitavelmente deixará passar coisas; a detecção e a remediação também precisam acompanhar.
Um membro da equipe do Claude Code explicou assim: desacelerar de fato reduz erros, mas principalmente porque você está fazendo menos de tudo. Por isso, eles preferem gastar esforço em encontrar problemas mais rápido e corrigi-los mais rápido.
Quando uma pessoa escreve código com IA, o que precisa ser aceito
A revisão por IA só dá opiniões; você continua sendo quem toma a decisão.
Então, não corra para buscar "não precisar olhar" — em vez disso, primeiro faça a IA responder três perguntas a cada entrega.
Primeiro, como foi verificado?
Quais verificações foram executadas, quais foram os resultados e quais casos ainda não estão cobertos.
Boris Cherny, o criador do Claude Code, disse que dar ao Claude uma forma de se verificar pode ser a coisa mais importante. Ele estima que isso pode fazer a qualidade do resultado final chegar a 2 a 3 vezes o original.

Boris Cherny recomenda deixar o Claude verificar seu próprio trabalho para formar um ciclo de feedback; ele estima que a qualidade do resultado final pode ser melhorada para 2–3 vezes.
Segundo, o que isso vai afetar?
Quais usuários, dados e permissões estão envolvidos na mudança.
Se você pedir à IA para adicionar um recurso de compartilhamento a uma ferramenta de relatórios, precisa perguntar claramente: quem pode abrir o link e o que pode ser visto depois de abri-lo.
Terceiro, como você reverte se algo der errado? Você consegue desligar o novo recurso com um clique e voltar à versão anterior.
Faça um commit de arquivo antes de começar e mantenha cada mudança o menor possível. Primeiro seja capaz de reverter, depois fale em revisar menos.
Além dessas três perguntas, cultive mais três hábitos.
Primeiro, revise com um "cérebro" diferente.
Na sessão em que o código é escrito, é mais fácil fechar os olhos para os próprios bugs.
Abra uma nova sessão, ou faça um subagente revisar com um contexto completamente novo; os comandos locais /code-review e /security-review também podem ser executados diretamente.
Segundo, classifique as mudanças em níveis.
Para mudanças de texto e ajustes de estilo, faça o merge depois que as verificações passarem e o efeito real for confirmado; para qualquer coisa envolvendo login, pagamento ou exclusão de dados, uma pessoa deve inspecionar cuidadosamente a lógica principal e adicionar testes direcionados.
Seja mais rigoroso no início e, depois que os processos de verificação e reversão funcionarem bem, reduza gradualmente a revisão manual de mudanças de baixo risco.
Terceiro, se três rodadas não resolverem, mude de abordagem.
Se a IA já revisou por três rodadas e ainda está dando voltas, não insista para uma quarta rodada — primeiro pergunte se a abordagem em si está errada.
O ponto mais importante: a IA dizer "passou" não significa que você concluiu a aceitação.
Você a fez escrever o código, e você também deve ser responsável pelos resultados depois que ele entrar no ar.
O objetivo da equipe do Claude Code é fazer com que a maioria dos PRs envolva no máximo uma pessoa, mantendo a taxa de reversão e a taxa de incidentes sob controle.
A atenção humana deve ser colocada mais em julgar riscos, confirmar se as verificações são suficientes e como remediar as coisas após a ocorrência de erros.
As pessoas não precisam ler cada linha de código, mas cada lançamento deve ter alguém responsável por ele.
Referências:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Editor: Yuanyu
Este artigo vem da conta pública do WeChat "Xinzhiyuan" (ID: AI_era), autor: ASI Revelation