
Environ 90 % du code de Claude Code lui-même a déjà été confié à Claude pour l'écrire.
Maintenant que l'IA écrit le code, le nombre de modifications a augmenté en conséquence : de juin à septembre, le nombre de PR fusionnées dans la base de code a plus que doublé.
Dans l'ensemble d'Anthropic, les modifications fusionnées chaque jour dans la base de code principale sont passées d'environ 2 500 en mai à plus de 30 000 en septembre.
Avec autant de code, les humains peuvent-ils encore suivre la lecture ? Et si même la relecture est confiée à l'IA, qui juge si elle a commis une erreur ?
Le 15 octobre, l'équipe Claude Code a publiquement dévoilé son processus interne de relecture de code, révélant que, bien que le nombre de PR ait doublé, la proportion de PR nécessitant un retour arrière a en réalité diminué de plus de 40 % par rapport à cela.
Ils y sont parvenus grâce à six niveaux de vérification, plus un mécanisme de secours pour une détection rapide et un retour arrière rapide.
Le jugement de l'équipe Claude Code est le suivant :
À cette échelle, une relecture humaine ligne par ligne n'est plus réaliste.
Mais ils n'ont pas supprimé la relecture ; ils ont plutôt confié la majeure partie du travail de lecture du code aux machines.
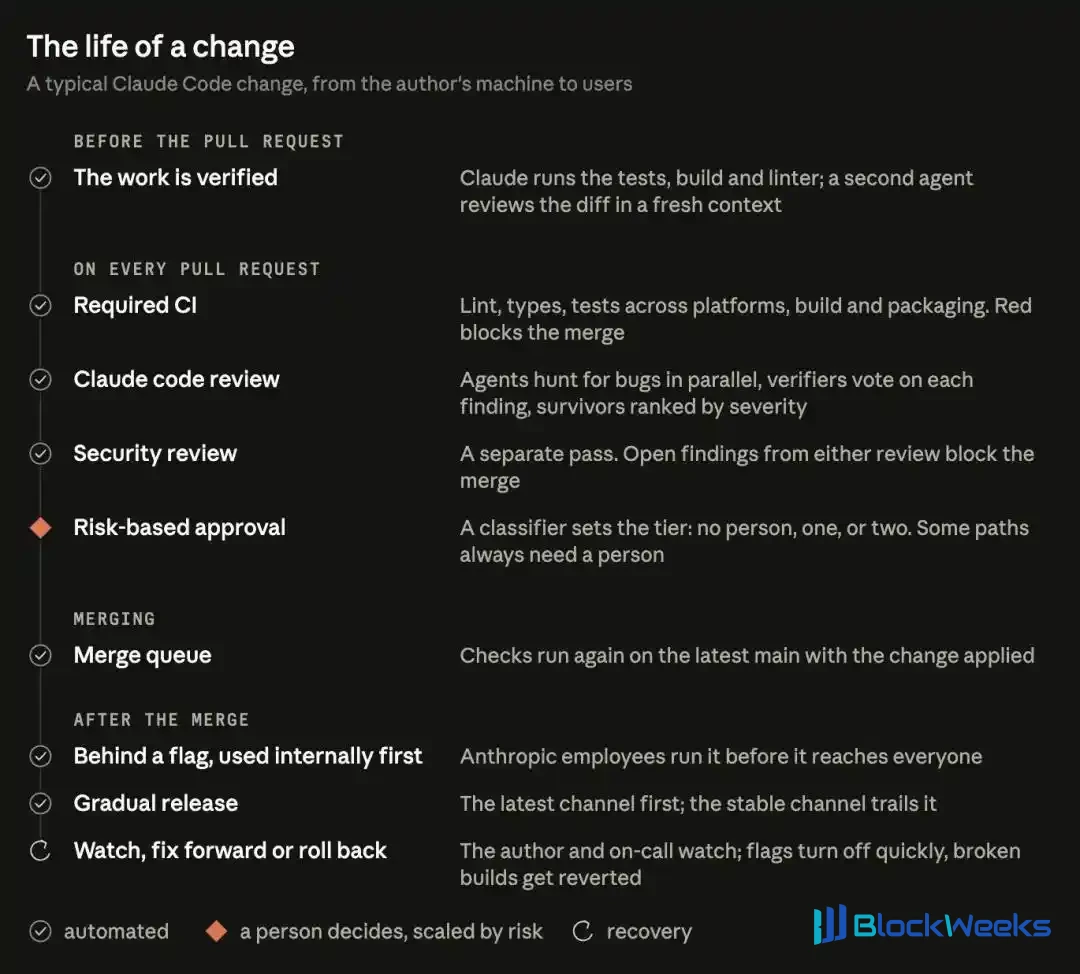
Avant qu'un morceau de code écrit par l'IA ne soit mis en ligne, il doit d'abord exécuter les tests, subir une relecture par l'IA et une relecture de sécurité, puis, en fonction du risque, une décision est prise quant à savoir si une approbation humaine est nécessaire.
Du point de vue de l'équipe Claude Code, « quelqu'un a-t-il lu ce code » n'est pas une question suffisamment précise.
La vraie question devrait être :
Qu'est-ce qui pourrait mal tourner avec cette modification, et si cela tourne mal, quelle vérification devrait l'arrêter ?
Avant la relecture humaine , l'IA présente d'abord les résultats de vérification
Une seule modification doit passer six vérifications, avec un filet de sécurité à la fin.
La première porte se présente avant la création d'une demande de fusion (PR).
Claude doit exécuter les tests et terminer la compilation ; pour les modifications impliquant l'interface, il doit également prendre des captures d'écran pour les comparer aux maquettes de conception.
Ensuite, un sous-agent utilisant un contexte neuf est envoyé pour relire le diff du code ; il n'a pas participé à l'écriture du code et est dédié à la recherche de fautes.
L'exigence officielle est très claire :
Claude doit présenter les commandes exécutées et leur sortie ; répondre simplement « tous les tests sont passés » ne compte pas.
Les développeurs ordinaires peuvent faire de même : lorsqu'ils confient une tâche à l'IA, ils doivent aussi indiquer clairement comment l'acceptation sera vérifiée.
La deuxième porte est la relecture par l'IA sur la PR.
Plusieurs agents recherchent des bugs en parallèle, et un autre groupe vote pour vérifier. Ce n'est que lorsqu'un nombre suffisant de votes est atteint que le problème sera publié sur la PR.
Les commentaires concernant uniquement le style de code, les indices de diagnostic ou le nettoyage du code ne seront pas publiés sur la PR et sont directement filtrés.
Lorsque ce système de révision a été lancé pour la première fois en mars, la proportion de PR internes recevant des commentaires de révision substantiels est passée de 16 % à 54 %.
La troisième porte est la révision de sécurité.
Au sein de l'équipe, tant que les constats laissés par la révision de code ou la révision de sécurité restent non résolus, la PR ne peut pas être fusionnée : soit les corriger, soit les clore avec une justification écrite.
La quatrième porte est constituée des vérifications d'intégration continue (CI), incluant les normes de code, la vérification de types, les tests de plateforme et l'empaquetage de build.
Une simple modification d'un outil en ligne de commande (CLI) ordinaire peut devoir exécuter des dizaines de vérifications avant d'être remise à une révision humaine.
Les problèmes récurrents doivent également devenir la base de la prochaine série de vérifications.
CLAUDE.md consigne les conventions du projet, et REVIEW.md indique au réviseur sur quoi se concentrer et ce qui peut être ignoré, afin que les problèmes trouvés cette fois deviennent une expérience pour la prochaine révision.
Lorsqu'un même commentaire est mentionné pour la troisième fois, il doit être inscrit dans les règles.
La cinquième porte est l'approbation humaine, qui est la plus critique ; nous en discuterons en détail dans la section suivante.
La sixième porte est la fusion et la publication.
Après qu'une modification a passé les portes précédentes, elle doit encore entrer dans la file de fusion et attendre son tour.
Lorsque son tour arrive, le système la place sur la dernière version de la branche principale, et toutes les vérifications sont exécutées à nouveau.
Cette étape protège contre le fait que « chaque partie est correcte prise isolément, mais des problèmes surgissent lorsqu'elles sont combinées ».
Après la fusion, les nouvelles fonctionnalités ne sont pas non plus immédiatement poussées vers tous les utilisateurs.
Elles sont d'abord masquées derrière des feature flags et ouvertes uniquement aux employés internes d'Anthropic. Les employés les utilisent intensivement chaque jour et rencontrent souvent des problèmes plus tôt que les utilisateurs externes.
Et le feature flag est comme un interrupteur principal : sans modifier le code ni republier une version, il peut décider si une fonctionnalité est activée ou désactivée.
Enfin, il y a le plan de repli.
Si un problème survient, actionnez d'abord l'interrupteur principal.
L'équipe assure une astreinte tournante chaque semaine, et chaque post-mortem d'incident doit poser la question : à quelle porte aurait-on dû l'arrêter ?
Ainsi, la révision n'a pas disparu — elle est devenue une couche après l'autre de vérifications qui traversent le développement, la fusion et la publication.
Où se situent les limites de l'approbation sans intervention humaine
Après que les quatre premières portes sont toutes au vert, la cinquième porte décide, en fonction de la stratification des risques, combien de personnes doivent approuver cette modification.
La documentation, les textes, les fonctionnalités visibles uniquement en interne et les nouvelles modifications masquées derrière des flags présentent un faible risque ; une fois la révision automatisée et les contrôles de sécurité passés, elles peuvent sauter l'approbation humaine.
Les modifications de produit ordinaires, ainsi que les zones sensibles comme la mise en cache, l'auto-updater et les prompts système, nécessitent une personne.
Le code à plus haut risque, ainsi qu'une poignée de chemins désignés, nécessitent deux personnes.
À première vue, les modifications à faible risque sont déjà « sans conducteur » ?
Ce n'est pas si simple.
Le niveau de risque est déterminé par la modification elle-même : le premier classificateur lit le code et fixe le risque, puis le second décide si une approbation humaine supplémentaire est nécessaire.
Les chemins sensibles marqués par les code owners, ainsi que tous les fichiers de workflow CI, doivent être révisés par un humain.
Le canal d'approbation allégé a aussi un seuil : il n'est ouvert qu'aux personnes figurant sur la liste des « auteurs de confiance » du dépôt ; toute personne hors de cette liste doit trouver une autre personne pour approuver.
La personne qui dirige l'IA pour écrire du code compte elle-même comme réviseur, et doit assumer la responsabilité de la modification comme si elle avait écrit le code à la main.
L'approbation sans intervention humaine ne signifie pas l'absence de responsabilité.
Les humains doivent décider si une fonctionnalité doit être construite, si l'architecture est raisonnable et si les vérifications existantes peuvent couvrir le risque de cette modification.
Ainsi, l'équipe de Claude Code a une règle : le code que vous fusionnez — si quelque chose ne va pas, c'est généralement vous qui le corrigez.
Avant de cliquer sur approuver, le relecteur doit pouvoir expliquer clairement : ce que ces vérifications ont validé, et quels risques restent non couverts.
Si vous ne pouvez pas l'expliquer, ne vous précipitez pas pour cliquer sur approuver — ajoutez d'abord la relecture nécessaire.
La relecture par IA peut aussi échouer
La relecture automatisée peut aussi se retrouver bloquée.
Une PR pour un projet CLI a passé plus de cinquante cycles de relecture et de corrections en une nuit, jusqu'à ce que l'auteur finisse par arrêter manuellement.
Un humain peut ignorer un problème mineur en une seconde, mais l'IA ne le fera pas — elle ira consciencieusement le corriger, et après correction il y a un nouveau commit, et un nouveau cycle de relecture.
L'équipe a utilisé git blame pour remonter et a constaté que, parmi les problèmes signalés à plusieurs reprises par le relecteur, environ 59 % étaient du code ancien qui existait avant le premier cycle de relecture. Il trouvait rarement de nouveaux bugs ; à chaque cycle, il ne faisait que déterrer quelques anciens de plus.
Par la suite, ils ont modifié quatre règles :
Si après trois cycles ce n'est toujours pas passé, rappeler à l'auteur de prendre du recul et de repenser l'approche ;
Après les premiers cycles, ne relire que les modifications nouvellement ajoutées ;
Signaler tous les problèmes du même type en une seule fois ;
Ne pas répéter les problèmes déjà signalés.
L'effet a été immédiat.
La part des PR internes passant après un cycle de relecture et de corrections est passée de 65 % à 78 % ; celles nécessitant cinq cycles ou plus sont tombées de 8,9 % à 1,5 % ; le nombre moyen de relectures est passé de 2,08 à 1,32.

Après ajustement des règles de re-relecture, le taux de réussite après un cycle de relecture et de corrections est passé de 65 % à 78 %, et le nombre moyen de relectures est tombé de 2,08 à 1,32.
L'art de la relecture consiste pour moitié à trouver des problèmes et pour moitié à savoir quand s'arrêter.
Une relecture à plusieurs niveaux signifie-t-elle qu'il n'y a aucune faille ?
Anthropic lui-même a donné un contre-exemple.
Le 26 mars, Claude Code a livré une optimisation : lorsqu'une session reste inactive plus d'une heure, nettoyer une fois les anciens enregistrements de raisonnement.
Mais un bug l'a fait exécuter le nettoyage à chaque tour après la reprise d'une conversation. En conséquence, Claude est devenu oublieux, a commencé à se répéter et a utilisé les outils de manière anormale. Le bug n'a été corrigé que le 10 avril.

Après une période d'inactivité, les anciens raisonnements auraient dû être nettoyés une seule fois, mais en réalité ils étaient nettoyés à chaque tour ; le cadre rouge marque le contenu supprimé par erreur.
Le post-mortem officiel du 23 avril a admis :
Ce changement a passé plusieurs cycles de relecture humaine et automatisée ; les tests unitaires, les tests de bout en bout et le dogfooding interne n'ont pas réussi à le détecter, et la seule confirmation de la cause racine a pris plus d'une semaine.
Le tournant est venu lors du post-mortem.
L'équipe a réexaminé avec Code Review la PR qui avait causé l'incident ; lorsqu'on lui a fourni un contexte suffisant provenant des dépôts concernés, Opus 4.7 a trouvé le bug, tandis qu'Opus 4.6 ne l'a pas trouvé.
Ce backtest a montré que la capacité du modèle et l'exhaustivité du contexte influencent tous deux les résultats de détection. Ils ont donc fait en sorte que la relecture intègre davantage de dépôts.
Aujourd'hui, chaque incident devient une question d'examen.
L'équipe collecte les PR, fait confirmer les bugs qu'elles contiennent un par un par des ingénieurs familiers avec le code, et les compile en un ensemble de tests.
Le reviewer s'exécute contre cet ensemble de tests chaque jour. Chaque fois que les prompts, les outils ou les modèles sont ajustés, il est également utilisé pour vérifier l'effet : si le score ne s'améliore pas, l'ajustement n'est pas adopté.
L'équipe n'a pas non plus exagéré les choses.
Après la mise en production des changements, les développeurs et le personnel d'astreinte doivent encore repérer les anomalies à l'aide de tableaux de bord de données.
Le mécanisme de « disjoncteur » qui resserre automatiquement les approbations en fonction de métriques telles que le taux de rollback n'a pas encore été construit. Les ingénieurs veulent d'abord ajouter cette safeguard avant de laisser davantage de changements passer en approbation zéro humain.
La revue manquera inévitablement des choses ; la détection et la remédiation doivent aussi suivre.
Un membre de l'équipe Claude Code l'a expliqué ainsi : ralentir réduit effectivement les erreurs, mais principalement parce que vous faites moins de tout. Ils préfèrent donc consacrer leurs efforts à trouver les problèmes plus vite et à les corriger plus vite.
Quand une personne écrit du code avec l'IA, ce qu'il faut accepter
La revue par IA ne donne que des avis ; c'est toujours vous qui prenez la décision.
Donc, ne vous précipitez pas à poursuivre le « ne pas avoir besoin de regarder » — au contraire, faites d'abord en sorte que l'IA réponde à trois questions à chaque livraison.
Premièrement, comment cela a-t-il été vérifié ?
Quelles vérifications ont été exécutées, quels en ont été les résultats, et quels cas ne sont pas encore couverts.
Boris Cherny, le créateur de Claude Code, a déclaré que donner à Claude un moyen de se vérifier lui-même est peut-être la chose la plus importante. Il estime que cela peut porter la qualité du résultat final à 2 ou 3 fois l'original.

Boris Cherny recommande de laisser Claude vérifier son propre travail pour former une boucle de rétroaction ; il estime que la qualité du résultat final peut être améliorée de 2 à 3 fois.
Deuxièmement, qu'est-ce que cela affectera-t-il ?
Quels utilisateurs, données et permissions sont concernés par le changement.
Si vous faites ajouter par l'IA une fonction de partage à un outil de reporting, vous devez demander clairement : qui peut ouvrir le lien, et que peut-on voir après l'avoir ouvert.
Troisièmement, comment revenir en arrière si quelque chose ne va pas ? Pouvez-vous désactiver la nouvelle fonctionnalité en un clic et revenir à la version précédente.
Validez une archive avant de commencer, et gardez chaque changement aussi petit que possible. Sachez d'abord revenir en arrière, puis parlez de réduire la revue.
En plus de ces trois questions, cultivez trois autres habitudes.
Premièrement, révisez avec un autre « cerveau ».
Dans la session où le code est écrit, il est plus facile de fermer les yeux sur ses propres bugs.
Ouvrez une nouvelle session, ou faites réviser par un sous-agent avec un contexte complètement neuf ; les commandes locales /code-review et /security-review peuvent aussi être exécutées directement.
Deuxièmement, classez les changements par niveaux.
Pour les modifications de texte et les ajustements de style, fusionnez après que les vérifications ont passé et que l'effet réel est confirmé ; pour tout ce qui touche à la connexion, au paiement ou à la suppression de données, un humain doit inspecter soigneusement la logique clé et ajouter des tests ciblés.
Soyez plus strict au début, et une fois que les processus de vérification et de rollback fonctionnent bien, réduisez progressivement la revue manuelle des changements à faible risque.
Troisièmement, si trois tours ne suffisent pas, changez d'approche.
Si l'IA a révisé pendant trois tours et tourne encore en rond, ne la poussez pas pour un quatrième tour — demandez d'abord si l'approche elle-même est erronée.
Le point le plus important : que l'IA dise « réussi » ne signifie pas que vous avez terminé l'acceptation.
Vous lui avez fait écrire le code, et vous devez aussi être responsable des résultats après sa mise en production.
L'objectif de l'équipe Claude Code est que la plupart des PR n'impliquent au plus qu'une seule personne, tout en maintenant le taux de rollback et le taux d'incidents sous contrôle.
L'attention humaine devrait davantage se porter sur l'évaluation des risques, la confirmation que les vérifications sont suffisantes, et sur la manière de remédier aux choses après que des erreurs se produisent.
Les gens n'ont pas besoin de lire chaque ligne de code, mais chaque version publiée doit avoir quelqu'un qui en soit responsable.
Références :
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Éditeur : Yuanyu
Cet article provient du compte public WeChat « Xinzhiyuan » (ID : AI_era), auteur : ASI Revelation