Não é possível, os benchmarks realmente evoluíram para esse nível agora???
Desta vez não se trata mais de resolver problemas de prática—eles simplesmente dão à IA um conjunto de condições experimentais e deixam que ela pesquise por conta própria e preveja os resultados de experimentos reais de bancada antes que aconteçam...
Por exemplo, se a mesma reação for realizada sob várias condições diferentes, qual delas produzirá mais do produto alvo? Entre um lote de variantes de anticorpos, qual terá níveis de expressão mais altos?
As respostas ficam escondidas primeiro, e quando a IA entrega seu trabalho, os resultados medidos de fato são comparados com ele.
E sabe de uma coisa, isso é realmente algo que vale a pena testar agora.
Nos últimos dois anos, a abordagem de IA para a Ciência foi se aprofundando cada vez mais—a IA já consegue buscar literatura de forma autônoma, usar softwares e trabalhar continuamente por horas a fio para concluir uma tarefa de análise.
Naturalmente, todos começaram a avançar para a próxima etapa: Que tipo de capacidades de pesquisa científica nós realmente queremos que a IA tenha?
A previsão de resultados de bancada é um dos itens com considerável valor prático.
Isso exige que a IA entenda o objetivo experimental e extraia mecanismos relevantes do conhecimento existente, para que possa ajudar melhor os pesquisadores a selecionar direções de pesquisa que valham a pena explorar mais.
O novo benchmark Science Prediction Universe (SPU, abreviado), liderado e lançado pela UniPat AI, percebeu isso com perspicácia.
116 tarefas, 4.207 experimentos de bancada, abrangendo química, ciência dos materiais, biologia e medicina. Os consultores do benchmark e os colaboradores de bancada também vêm de universidades como Stanford, Cornell e Harvard, bem como de instituições de pesquisa de ponta e empresas de biotecnologia da área.
O modelo segue um regime de jornada de trabalho de 8 horas a cada vez, é equipado com uma H20 e então decide de forma autônoma como usar recursos de recuperação e computação para formar previsões experimentais.
Os resultados surpreenderam a todos.
Mesmo modelos fortes como Opus 5.5 e GPT-6 Astra estão, de acordo com os dados, ainda muito longe de realmente conseguir realizar previsões...
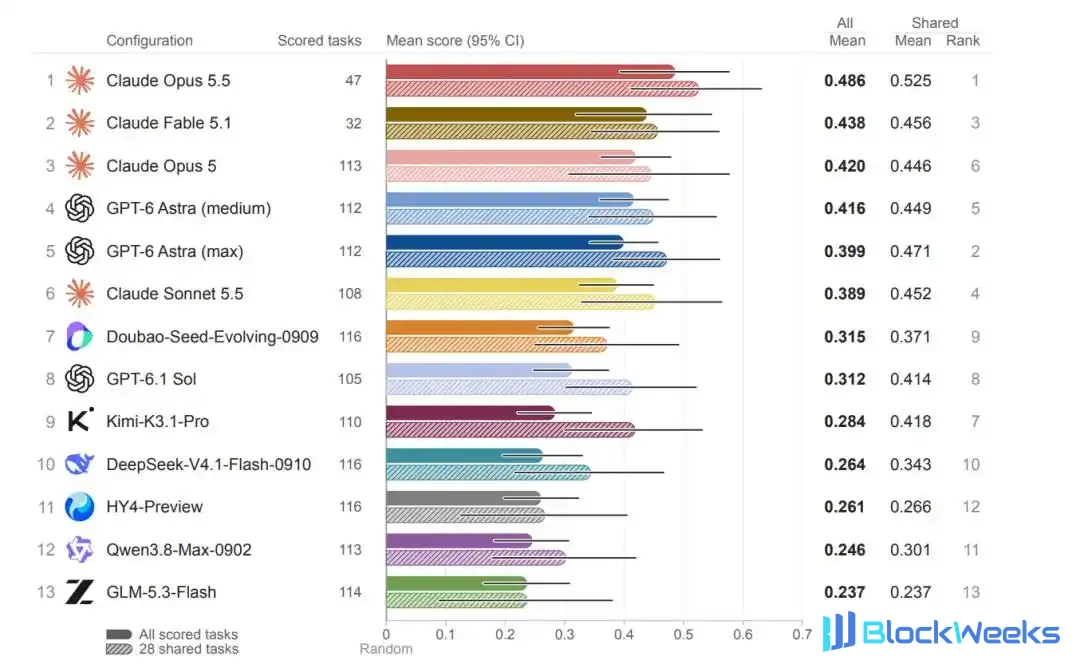
△Pontuações médias de cada configuração em todas as tarefas pontuadas
Preciso dizer, o SPU serviu um prato difícil para todos os modelos de pesquisa.
Aquelas capacidades de pesquisa que antes eram invisíveis e intangíveis agora se tornaram valores numéricos que podem ser avaliados de forma uniforme e estudados continuamente.
Quanto a como o julgamento científico da IA se desenvolve passo a passo, agora há uma base mais concreta para discussão.
Previsão de bancada: vale a pena um exame separado para os modelos
Voltando à previsão de bancada—em primeiro lugar, isso de fato não é uma questão nova.
Houve muitos momentos assim na história da ciência: faz-se um julgamento antes do experimento, e então se deixa o processo decidir—se estiver certo, permanece; se estiver errado, é derrubado.
A lógica específica do julgamento constitui o gosto de um cientista.
Com um gosto suficientemente bom e uma intuição suficientemente precisa, os cientistas podem obter grandes resultados mais rapidamente enquanto economizam recursos experimentais preciosos.
Afinal, apenas um experimento de bancada — para química, é preciso preparar reagentes, definir condições de reação e depois separar produtos; para biologia, também é preciso passar pela longa expressão de proteínas... O custo de tempo e o custo de ferramentas são, por si só, bastante caros, e se os resultados não forem ideais, é preciso repetir várias rodadas.
Portanto, prever antes de começar é a etapa mais valiosa do processo de pesquisa.

A única diferença é que, no passado, isso era feito puramente pelos próprios cientistas, e agora, na era da IA, os modelos também precisam ter essa capacidade, e também precisam de uma prova que possa pontuá-los.
Os benchmarks existentes ainda não conseguem cobrir isso completamente. Por exemplo, o BrainBench permite que os modelos julguem diretamente os resultados experimentais; o ScienceAgentBench concentra-se em concluir análises sobre dados existentes; e benchmarks de tarefas de longo horizonte, como o Terminal-Bench 4.0 e o Long-Horizon-TB, usam principalmente testes predefinidos para verificar as saídas das tarefas.
O SPU é diferente de todos eles.
Ele dá mais ênfase a testar o processo de pesquisa autônoma da IA em conjunto com a previsão de resultados de bancada, envolvendo tanto o desempenho preditivo quanto a capacidade de usar ferramentas científicas e executar tarefas de longo horizonte.

△O gráfico foi gerado por IA
Esse tipo de julgamento também foi organizado pelo SPU em tarefas claras.
100 tarefas públicas foram respectivamente retiradas de 85 artigos publicados recentemente. Especialistas da área organizaram as opções candidatas, materiais, condições e métodos de medição da pesquisa, mantendo resultados quantitativos completos como base para a pontuação.
Além disso, 16 tarefas privadas vêm de quatro grupos de experimentos de bancada colaborativos não publicados, envolvendo nanobodies VHH, condições de reação, eletrólitos e variantes de Magrolimab.
Um total de 32 subáreas e 4.207 experimentos, entre os quais a pesquisa pública fornece fontes de tarefas interdisciplinares, os resultados medidos ficam ocultos dos modelos, e os experimentos não publicados acrescentam testes independentes das respostas em artigos públicos.
Até certo ponto, isso pode impedir que os modelos tenham visto as questões com antecedência.

△Cobertura e fontes das tarefas do SPU
O processo de seleção das questões também é bastante criterioso.
Os especialistas dão prioridade a estudos com medições completas e condições claras; questões simples que podem ser ordenadas ao longo de uma única tendência são diretamente eliminadas, e questões com valores muito próximos também são consideradas de pouco valor de referência.
As questões que permanecem no final são todas mais difíceis e mais discriminativas.
Durante o processo específico de previsão, o modelo é obrigado a executar por oito horas a cada vez, equipado com uma CPU de 8 núcleos, 16 GiB de memória e uma H20, enquanto tem permissão para pesquisar online e instalar software de pesquisa científica.
Durante esse período, o modelo coletará evidências por conta própria, escolherá métodos computacionais e, finalmente, enviará o ranking previsto de baixo para alto para cada grupo de comparação.
Para evitar a contaminação de memória, o processo de pontuação também é conduzido inteiramente em um contêiner independente e offline; o AI é proibido de recuperar os resultados originais da pesquisa, e as saídas das ferramentas são automaticamente verificadas para identificar identificadores como o DOI e o título do artigo de origem.
Por fim, o sistema usa o coeficiente de correlação de Spearman para comparar o ranking previsto com o ranking medido.
Quanto mais próximo o coeficiente estiver de 1, mais próximo o ranking estará dos resultados experimentais.

△Processo de avaliação do SPU
Curiosamente, o SPU também presta atenção a muitos detalhes que os testes de benchmark não consideraram.
Por exemplo, em relação à pontuação final, o SPU considera se ela pode ter sido devida à sorte, caso tenha sido um acerto por acaso.
Então ele gera adicionalmente 4.000 rankings aleatórios para cada questão, usa o percentil 95 como limiar de nível aleatório e verifica se a submissão do modelo excede significativamente essa referência. Diferentes tarefas também têm bases de referência correspondentes.
O design de todo o SPU pode ser considerado cientificamente rigoroso.
O modelo deve, passo a passo dentro dele, julgar por si mesmo o que vale a pena computar e submeter sua previsão final.
Esse design não apenas ajuda a medir a capacidade atual de previsão em laboratório úmido da IA, mas também aponta a direção para que as equipes de pesquisa subsequentes melhorem continuamente os experimentos com a ajuda de métricas unificadas.
Dito isso, a seguir podemos também dar uma olhada juntos nos boletins da primeira leva de modelos de fronteira. Os detalhes valem bastante uma discussão separada.
O novo teste faz os modelos de fronteira entrarem em colapso coletivamente
A primeira rodada de avaliação sistemática do SPU cobre 12 modelos de fronteira e 13 configurações. As configurações aqui se referem ao modelo, à intensidade de raciocínio e ao framework de modelo utilizado.
Primeiro, vamos falar sobre os resultados gerais.
Em uma frase: nenhum deles é bom.
Em todas as tarefas pontuadas, a maior pontuação média foi do Claude Opus 5.5, com 0,486 pontos. Mas mesmo para ele, apenas metade das tarefas superou o nível aleatório.
Entre as 13 configurações, isso é quase sempre o caso; a proporção de tarefas que superam o limiar de nível aleatório é de apenas 34% a 52%.
Em outras palavras, todos os modelos presentes ainda têm um longo caminho a percorrer antes de uma previsão em laboratório úmido verdadeiramente confiável.

△Análise comparativa de comportamento do grupo líder e do grupo retardatário
No entanto, também há diferenças entre os modelos, e o desempenho médio pode ser dividido em dois níveis:
o grupo líder (6 modelos) e o grupo retardatário (7 modelos).
Em comparações com as mesmas questões, o grupo líder, em média, ainda é cerca de 0,15 pontos mais alto que os outros sete.
Há outro detalhe que vale a pena notar. Cerca de 9% das tarefas no grupo líder pontuaram abaixo de 0, enquanto para as outras sete configurações essa proporção pode chegar a 22%.
Aqui, 0 se refere à pontuação média de um ranking válido aleatório; uma pontuação negativa significa que a previsão está negativamente correlacionada com o ranking real.
De onde exatamente vem a diferença? A equipe de pesquisa investigou um passo mais fundo.
Eles primeiro combinaram as previsões de outros modelos sobre a mesma questão em um ranking de referência, depois emparelharam os experimentos dois a dois, compararam-nos com os resultados medidos e verificaram se cada modelo individualmente os classificava corretamente.
Nos pares de experimentos em que o ranking de referência estava correto, o grupo líder os classificou corretamente em 86% das vezes, enquanto as outras sete configurações alcançaram 78%; para os pares de experimentos em que o ranking de referência estava errado, ambos os grupos os classificaram corretamente de forma independente em cerca de 30%.
Portanto, na verdade, parte da vantagem do grupo líder se reflete precisamente nos pontos em que as previsões estão conjuntamente corretas; nessa parte, o grupo líder é sempre mais estável.

Quanto ao motivo pelo qual o modelo se desvia do julgamento correto, os registros de execução contêm pistas mais específicas.
Tome a tarefa de solução como exemplo. Para a mesma reação de polimerização, 12 solventes foram alterados em sequência, e a tarefa exigia a classificação pela massa do polímero finalmente separado.
O Opus 5.5 obteve 0,874, enquanto o Qwen3.8 obteve -0,126. As 12 condições candidatas de solvente foram emparelhadas duas a duas, totalizando 66 pares; o primeiro classificou 56 pares corretamente, e o segundo classificou 30 pares corretamente.

△Duas execuções do Opus e do Qwen na mesma tarefa
A análise descobriu que isso ocorre porque os dois diferiam nos fatores em que se concentravam desde o início:
O Qwen3.8 classificou principalmente com base em quanto etileno o solvente consegue dissolver, enquanto o Opus 5.5 prestou mais atenção à miscibilidade das matérias-primas e à compatibilidade do catalisador no solvente.
Embora o Qwen3.8 também tenha descoberto essa questão durante o processo de cálculo, ele acabou não conseguindo alterar diretamente a base de classificação finalmente adotada pelo modelo.
Portanto, o estágio em que os erros de previsão têm maior probabilidade de ocorrer é a etapa de escolher a base de julgamento. O modelo também precisa aprender a ajustar o método de classificação em tempo real de acordo com as pistas, para que essas descobertas possam realmente afetar a resposta.
Decompostas, essas diferenças também variam conforme a disciplina e a tarefa específicas.
Entre os resultados pontuados para cada disciplina nas tarefas públicas, a maior pontuação média em química foi do Opus 5.5, em ciência dos materiais foi do Fable 5.1, em biologia foi do GPT-6 Astra Medium, e em medicina foi do Opus 5.
P.S. O Fable 5.1 e o Opus 5.5 exibiram comportamento de recusa em responder.

△Pontuações de cada modelo nas quatro disciplinas
Portanto, se você está se preparando para fazer a IA participar de um certo tipo de pesquisa, talvez seja melhor primeiro encontrar uma tarefa relacionada e usar o SPU para testá-la, e só prosseguir com experimentos formais depois de confirmar que o modelo é realmente aplicável.
Os resultados das tarefas privadas tornam esse ponto ainda mais concreto.
Entre as 13 configurações, 12 tiveram pontuações médias significativamente superiores à classificação aleatória, e nenhuma diferença óbvia foi detectada entre as configurações. Em contrapartida, a variação trazida por diferentes tarefas foi particularmente marcante.
Para o mesmo lote de eletrólitos, ao prever a condutividade iônica, os coeficientes de correlação de classificação das 13 configurações ficaram concentrados na faixa de 0,89 a 0,95; ao mudar para a janela eletroquímica, as pontuações das 12 configurações que receberam pontuação variaram de -0,55 a 0,07, nenhuma ultrapassando o limiar de nível aleatório.
O modelo não mudou, mas, uma vez que o alvo de medição mudou, a distribuição das pontuações também mudou claramente.
Portanto, da próxima vez que você avaliar um modelo, dizer apenas que ele é bom em química não é específico o suficiente; você também precisa ver qual alvo de medição específico e quais condições experimentais ele está enfrentando.

△Desempenho de previsão de cada modelo nas 16 tarefas privadas
Aqui está outra coisa bastante contraintuitiva:
De modo geral, dar ao modelo mais tempo e maior intensidade de raciocínio deveria fazer a pontuação continuar subindo, certo?
Todos geralmente pensam assim, e todos fazem assim.
Mas adivinhe? Assim que os resultados do SPU saíram, eles nos deram uma bofetada direta na cara—
Sob as mesmas 8 horas de computação, a equipe de pesquisa ajustou o GPT-6 Astra da intensidade de raciocínio média para a mais alta. O tempo de execução mediano na intensidade mais alta aumentou para 4,8 vezes, e o custo mediano de API também aumentou para 5,3 vezes.
Mas a pontuação de previsão... quase não se moveu.
Hã? A equipe de pesquisa até voltou especificamente para examinar os registros de execução do modelo.
E ora, nas 79 tarefas concluídas, o GPT-6 Astra na intensidade de raciocínio mais alta geralmente já havia dado uma resposta até os 26% medianos da execução.
O modelo também não ficou ocioso depois; ele continuou calculando e revisando, mas esses foram todos ajustes finos e não se manifestaram como diferenças nos resultados.
Em outras palavras, maior intensidade de raciocínio não necessariamente torna os resultados melhores.

△Investimento e desempenho do GPT-6 Astra sob duas intensidades de raciocínio
Esse fenômeno também serve como um lembrete para a alocação de recursos do modelo: se você quer adicionar computação, não se precipite cegamente—isso consome tempo, mão de obra e pode nem compensar.
Em vez disso, você pode examinar os registros de execução com mais cuidado, primeiro entendendo completamente a qual julgamento a evidência recém-adicionada realmente corresponde, e então impulsionar propositalmente o poder de computação localmente.
Na verdade, um fenômeno semelhante também aparece no uso de ferramentas.
Em cada execução, o número mediano de categorias de métodos usadas pelo GPT-6 Astra Max é 4, enquanto para o Medium é 1, mas nenhuma diferença significativa nas pontuações foi detectada entre as duas configurações.
A razão é praticamente a mesma: boas ferramentas não foram usadas onde mais importava.
Por exemplo, com a amostragem de Monte Carlo, embora o modelo chame essa ferramenta na maioria das vezes, ela apenas adiciona uma margem de erro à classificação final e não afeta diretamente o resultado em si.

△Invocação de ferramentas de computação científica
Então, na verdade, usar mais ferramentas não é tão bom quanto usá-las com precisão.
O uso de GPU também oferece uma perspectiva interessante.
Mesmo com poder computacional de GPU suficiente fornecido, apenas 255 execuções realmente obtiveram sucesso na computação em GPU, menos de um quinto.
Modelos diferentes e disciplinas diferentes variam em suas execuções em GPU, então simplesmente olhar o número de invocações de GPU dificilmente pode indicar a capacidade de pesquisa de um modelo.
Para julgar se o poder computacional ajudou, você ainda precisa ver para que ele foi usado para computar, se os resultados da computação ajudaram na previsão e como esses resultados afetaram a classificação final.
O ponto-chave ainda é direcionar o poder computacional para as grandezas físicas relevantes para a classificação, para que o modelo possa completar as previsões com mais precisão.

△Estatísticas de uso de GPU
Olhando o custo em conjunto, o custo médio de API por execução entre as configurações varia de US$ 0,22 a US$ 65,91, uma diferença de nada menos que 300 vezes.
Isso significa que o SPU fornece tanto desempenho preditivo quanto custo de invocação, uma boa referência para equipes que se preparam para implantar modelos de pesquisa.
Das pontuações gerais às trajetórias por questão, o SPU desdobra as diferenças entre modelos em cada detalhe do julgamento científico, como poder computacional e custo.
O quanto os valores computados pela IA realmente ajudam na previsão; quando uma previsão dá errado, quais julgamentos devem ser reexaminados... tudo isso pode ser analisado mais a fundo combinando os resultados experimentais com os registros de execução.
A próxima rodada de melhoria, assim, tem uma direção clara para tentar:
De acordo com o SPU, o modelo pode detectar mais prontamente hipóteses errôneas e manter ou modificar classificações com mais justificativa. Após as mudanças, coloque-o de volta na mesma tarefa para ver se as previsões se tornam mais precisas.
Trazendo o "teste de compreensão" para a sala de exames do modelo
Pode-se dizer que o SPU é altamente consistente com os padrões de desenvolvimento do AI4S.
A avaliação do AI4S está gradualmente se aprofundando em estágios experimentais reais, e benchmarks orientados para a execução de experimentos também vêm surgindo este ano.
Mas além da execução, a previsão, como uma etapa inevitável no processo de pesquisa e a mais difícil de quantificar, finalmente tem uma forma mensurável.
Os benefícios se refletem em dois aspectos:
Pesquisadores podem, assim, analisar quais alvos de medição são mais fáceis de prever, quais tarefas diferem mais e como um julgamento errôneo se forma. Isso pode economizar recursos experimentais caros e preciosos e encurtar o tempo de decisão.
Para o desenvolvimento de modelos, isso também fornece uma referência mais específica para melhoria.
À medida que os tipos de experimentos aumentam, a avaliação também pode responder a perguntas mais específicas: para quais materiais, condições experimentais e métodos de medição as classificações dadas pela IA são mais confiáveis e mais dignas de referência.
Os cientistas podem, assim, acumular continuamente progresso em torno do mesmo tipo de questões.

Na verdade, o SPU é apenas a ponta do iceberg na série de avaliações de trabalho real do UniPat AI:
- ScienceVision: concentra-se em como os modelos obtêm evidências de objetos científicos tridimensionais e respondem a perguntas;
- PaperBenchX: transforma pesquisas publicadas em tarefas de reprodução de artigos executáveis e verificáveis;
- SaaS-Bench e EvoCode-Bench: examinam, respectivamente, os processos reais de software e o trabalho de desenvolvimento quando os requisitos mudam continuamente. ...
Esses trabalhos abrangem pesquisa científica, trabalho de escritório e desenvolvimento de software, e todos compartilham uma preocupação com a forma como a IA conclui tarefas após entrar em um trabalho específico, e como os resultados são verificados.
Isso também reflete indiretamente que a UniPat AI tem uma visão única do setor e um julgamento prospectivo em relação ao movimento da IA em direção à prática da pesquisa científica e até mesmo em direção ao mundo real.
A UniPat AI também demonstra um novo tipo de modelo de colaboração em IA:
Especialistas de domínio participam da triagem e revisão de tarefas, laboratórios parceiros fornecem tarefas não publicadas, e a equipe do projeto organiza experimentos de diferentes disciplinas em tarefas de avaliação unificadas.
Tomando o SPU como exemplo, ele é liderado pela UniPat AI, e as instituições dos membros consultivos incluem Stanford, Cornell, Harvard, UIC, Universidade de Pequim, HKUST e FutureHouse. Colaboradores de laboratório úmido da Yourui Saishi, Aibotaike, Deep Principle e Enhe Biology participaram do trabalho experimental relacionado.
Conhecimento interdisciplinar e recursos experimentais entram assim no mesmo processo de avaliação. O SPU não apenas carrega a seleção de problemas, mas também apresenta a colaboração necessária para organizar problemas de pesquisa científica em tarefas executáveis.
Atualmente, as 100 tarefas públicas relacionadas ao SPU estão planejadas para serem lançadas como pacotes completos de tarefas Harbor; as 16 tarefas privadas permanecerão privadas para avaliação controlada. Tanto o conjunto de dados quanto o código foram disponibilizados como código aberto.
É verdade que a IA de hoje ainda é apenas uma novata diante desse mecanismo SPU.
Ela pode usar ferramentas na velocidade de um raio e, em 8 horas, instalar três conjuntos de software, terminar de executar DFT e depois executar Monte Carlo, mas no julgamento mais crítico, ela ainda não aprendeu a se fazer uma pergunta: a quantidade que estou calculando é exatamente a quantidade que o experimento realmente precisa medir.
Mas, à medida que tais tarefas continuam a se acumular, também se tornará claro que tipo de trabalho de pesquisa científica a IA pode realizar.
O SPU mediu essa distância, e cada exame subsequente é um registro da IA se aproximando da bancada experimental real.
Este artigo vem da conta pública do WeChat "Quantum位" (ID: QbitAI), autor: Focus on Frontier Technology