Heutige Agents können bereits Werkzeuge aufrufen, Dateien ändern und Tests ausführen, aber können sie bei einem großen, über lange Zeit gewachsenen Softwaresystem von einer neuen Anforderung ausgehend ein vollständiges Feature liefern?
Wenn ein Produktmanager eine neue Anforderung vorschlägt, erhalten Entwickler oft keine Dateiliste oder Funktionssignaturen. Sie müssen zunächst die Randbedingungen verstehen, Modulabhängigkeiten nachverfolgen und dann bestimmen, wo geändert werden muss, wie geändert werden muss und wie nachgewiesen werden kann, dass die Änderungen korrekt sind. Diese Analysen beeinflussen die nachfolgende Lieferung.
Die Fudan University, die City University of Hong Kong, die The Chinese University of Hong Kong und weitere Institutionen schlagen LoLBench vor, das Agents in Softwaresysteme mit durchschnittlich etwa 2,4 Millionen Zeilen Quellcode versetzt, den vollständigen Prozess vom Feature-Vorschlag bis zur Modullieferung bewertet und die Wahrnehmungsfähigkeit, Anforderungen im System zu verankern, sowie die Umsetzungsfähigkeit, modulübergreifende Änderungen abzuschließen, testet.
Link zum Paper: https://arxiv.org/abs/2609.37143
Datensatz: https://huggingface.co/datasets/lolbench26/LoLBench
Die Experimente legen einen entscheidenden Bruchpunkt offen: Ein Agent kann eine korrekte lokale Änderung vornehmen, aber Änderungen in anderen Modulen übersehen, die synchronisiert werden müssen. Selbst mit ergänzender Umsetzungsanleitung bleiben die meisten Aufgaben ungelöst, und es ist noch ein weiter Weg vom Verstehen der Anforderungen bis zum Abschluss der Lieferung.
Neudefinition langhorizontiger Code-Aufgaben
Welche Art von langhorizontiger Code-Aufgabe hat tatsächlichen ingenieurtechnischen Wert?
"Langhorizontig" lässt sich nicht allein anhand des Zeitaufwands, der Anzahl der Runden oder des Token-Verbrauchs beurteilen. Wenn man einen Agent beispielsweise auffordert, jede Minute eine Zahl auszugeben und von 1 bis 1000 zu zählen, dauert das lange, erfordert aber nur eine einfache Schleife. Lokale Fehlerbehebungsaufgaben im Stil von SWE-bench können die Herausforderung von der Anforderungsanalyse bis zur Modullieferung ebenfalls nicht abdecken.
Die langhorizontigen Code-Aufgaben, auf die sich LoLBench konzentriert, sind Modulentwicklung für komplexe Systeme. Nach Erhalt einer neuen Anforderung analysieren Entwickler wiederholt: Welche Verhaltensweisen müssen implementiert werden? Kann die bestehende Architektur sie unterstützen? Welche Abhängigkeiten werden betroffen sein? Wie lässt sich das verifizieren? LoLBench bezieht auch diese in den Köpfen der Entwickler verborgene Analyse in die Bewertung ein und lässt den Agent den Umsetzungsplan selbstständig aus der Nutzerabsicht ableiten.
Solche Aufgaben weisen gleichzeitig Wahrnehmungskomplexität und Umsetzungskomplexität auf: Erstere ist die Schwierigkeit, den Vorschlag zu verstehen, implizite Randbedingungen und modulübergreifende Abhängigkeiten zu identifizieren und den Änderungsumfang sowie die Umsetzungsspezifikation abzuleiten; Letztere ist die Schwierigkeit, die Spezifikation in korrekte dateiübergreifende Änderungen umzusetzen und durch Tests und Reparaturen zu verhindern, dass bestehende Funktionalität beeinträchtigt wird.
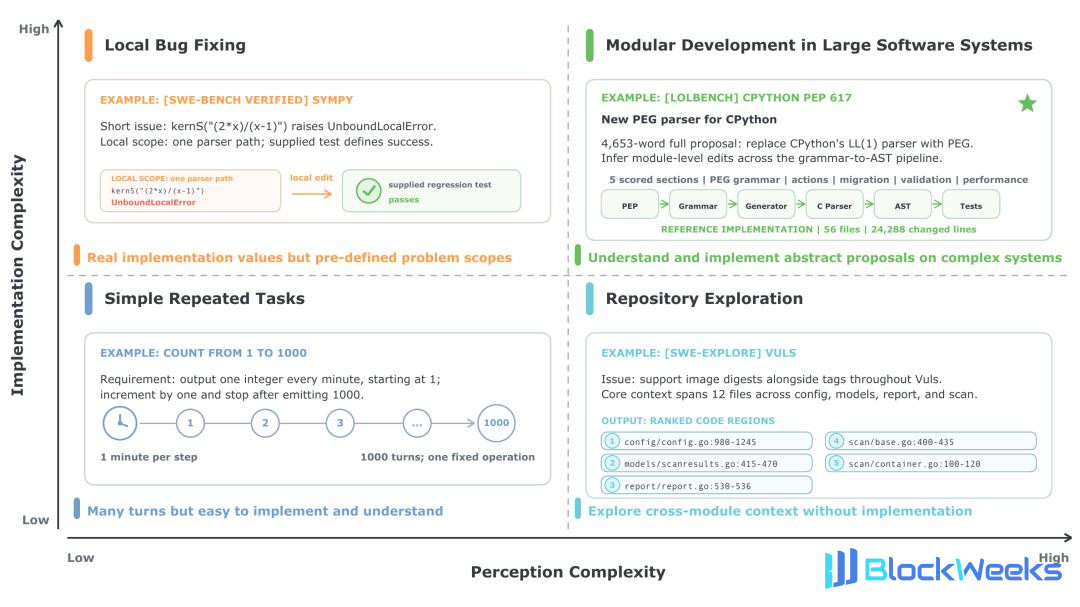
Abbildung 1 Vergleich von Wahrnehmungskomplexität und Umsetzungskomplexität.
Wie LoLBench beide Komplexitätsarten gleichzeitig bewertet
Umsetzungsspezifikationen aus Feature-Vorschlägen ableiten
LoLBench wählt 100 Aufgaben aus Community-Enhancement-Proposals und den zugehörigen zusammengeführten PRs aus, die 29 Systeme, 8 Sprachen und 5 Domänen abdecken.
Der Agent erhält vor der Umsetzung nur den Vorschlag und das Code-Repository; der Vorschlag umfasst durchschnittlich etwa 5.000 englische Wörter. Die Bewertung erfolgt in einer Offline-Docker-Umgebung, um zu verhindern, dass der Agent die Upstream-Implementierungen abruft.
Zum Beispiel schlägt PEP 617 [1] vor, den LL(1)-Parser von CPython durch PEG zu ersetzen, und die Implementierung erfordert die Verbindung von Grammatikdefinitionen, Parsergenerierung, abstrakten Syntaxbäumen und Fehlerberichterstattung. Der Agent muss die gesamte Implementierungskette identifizieren.
In Bezug auf die Wahrnehmungskomplexität beträgt die durchschnittliche Erwähnungsrate der Zielklassennamen im Vorschlag in der Referenzimplementierung von LoLBench nur 7,3 %, weniger als die Hälfte von SWE-bench Verified (15,9 %) und weniger als ein Fünftel von FeatureBench (38,7 %). Der Agent muss die Verbindung zwischen Anforderungen und Code selbst ableiten.
Spezifikationen in Engineering-Lieferung umwandeln
In Bezug auf die Implementierungskomplexität umfassen die LoLBench-Repositories durchschnittlich etwa 2,4 Millionen Zeilen Quellcode, etwa das 9,4-Fache von SWE-bench Verified und das 4,9-Fache von FeatureBench; die Implementierungen ändern durchschnittlich 5.499 Zeilen, verglichen mit 38 Zeilen und 2.050 Zeilen bei den beiden letzteren. Jede Aufgabe ändert durchschnittlich 64,9 Dateien, 40,1 Klassen und 195,9 Funktionen; die Anzahl der Dateien ist 25-mal bzw. 4,2-mal so hoch wie bei den beiden. Die modulübergreifende Koordination und Verifikation sind schwieriger.

Tabelle 1 Vergleich von LoLBench mit bestehenden Bewertungssätzen für Code-Aufgaben.
LoLBench überprüft die Korrektheit der Lieferung durch zwei Arten von Tests: Tests für neue Funktionen (F2P) erfordern ein Fehlschlagen vor der Implementierung und ein Bestehen nach der Implementierung; F2P überprüft das Verhalten über öffentliche Schnittstellen und erlaubt unterschiedliche interne Implementierungen. Regressionstests (P2P) erfordern ein Bestehen sowohl vor als auch nach der Implementierung.
Aufbauend auf den ursprünglichen Tests des Projekts konstruiert das Forschungsteam fehlerhafte Implementierungen wie fehlende Funktionen und manipulierte Anforderungen als Mutanten, ergänzt Testfälle zur Identifizierung übersehener Fehler und verbessert die Testabdeckung der Referenz-Patches.
Nach der Verbesserung steigt die Erkennungsrate von 1.688 Mutanten von etwa 61 % auf 96 %, und die durchschnittliche Zeilenabdeckung pro Aufgabe von F2P steigt von etwa 60 % auf 79 %.
Leistung und Engpässe von 28 Agent-Kombinationen
Bei Wechsel von Modellen oder Scaffolds beträgt die höchste Lösungsrate des Agenten nur 14 %
Das Forschungsteam bewertet 28 verfügbare Kombinationen aus 6 Frontier-Modellen und 5 Scaffolds, mit einem Zeitlimit von 6 Stunden pro Aufgabe. Opus 5 in Kombination mit Claude Code oder mini-SWE-agent erreichen beide gemeinsam die höchste Lösungsrate von 14 %, und der Median über alle Kombinationen beträgt nur 2 %.

Tabelle 2 Hauptergebnisse der Experimente im Paper
Bei ebenfalls verwendeten Opus 5 erreichten mini-SWE-agent und Claude Code die gleiche Lösungsrate, aber ersterer benötigte 3,2-mal so lange wie letzterer und generierte 5-mal so viele Tokens; mehr Verbrauch brachte keine höhere Lösungsrate.
Eine große Menge an Interaktion und Tokens wird für die Code-Lokalisierung aufgewendet
In Bezug auf den Token-Verbrauch entfielen, gemittelt über die Agenten, auf die Lokalisierungsphase 52,4 % der nicht zwischengespeicherten Eingabe-Tokens und 45,4 % der generierten Tokens. In Bezug auf die Anzahl der Interaktionsrunden des Agenten wies die Lokalisierungsphase ebenfalls deutlich mehr Interaktionsrunden auf als andere Phasen.

Abbildung 2 Durchschnittliche Anzahl der Interaktionsrunden in jeder Phase.
Bei bestehenden Dateien und Funktionen, die gegenüber der Referenzimplementierung geändert wurden, lag über alle 28 Agentengruppen hinweg die Präzision der Dateiänderungen zwischen 38,0 % und 80,4 % und der Recall zwischen 30,3 % und 65,0 %; die Präzision der Funktionsänderungen lag zwischen 54,2 % und 65,6 % und der Recall zwischen 20,8 % und 53,4 %. Die Lokalisierungsgenauigkeit des Codes ist gering, und die Abdeckung bleibt unvollständig.
Selbst nach Ergänzung von Änderungsanleitungen haben Agenten weiterhin Schwierigkeiten, vollständig zu liefern
Das Forschungsteam behielt den ursprünglichen Funktionsvorschlag bei und stellte zusätzlich einen aus der Referenzimplementierung exportierten Änderungsdateibaum sowie API-Implementierungsspezifikationen bereit, um den Agenten zu helfen, den Umfang der Änderungen zu bestimmen. Die Lösungsrate von Opus 5+Claude Code stieg von 14 % auf 34 %, GPT-5.6 Sol+Codex stieg von 3 % auf 25 %,
DeepSeek
V4 Flash+OpenCode stieg von 1 % auf 17 %.

Tabelle 3 Experimentelle Ergebnisse nach Ergänzung des Änderungsdateibaums und der API-Implementierungsspezifikationen
Die Ergänzung von Änderungsanleitungen kann die Wahrnehmungslast erleichtern, aber die beste Kombination hatte weiterhin 66 % der Aufgaben ungelöst. Agenten müssen weiterhin Module koordinieren, Schnittstellen implementieren und die Validierung bestehen, was darauf hindeutet, dass auch die Implementierungskomplexität großer Systeme sehr hoch ist.
Von der Codegenerierung hin zur Evolution großer Softwaresysteme
Diese Ergebnisse liefern testbare Richtungen für die Forschung und Entwicklung von Agenten: ob die Repository-Suche wichtige Abhängigkeiten abdecken kann, ob die Implementierungsspezifikationen vor dem Codieren vollständig sind und ob die Validierung modulübergreifende Auslassungen rechtzeitig erkennen kann.
Der Wert der Softwaretechnik liegt darin, ob Benutzeranforderungen zuverlässig erfüllt werden können. Agenten müssen verstehen, warum Änderungen erfolgen, wie sie das System beeinflussen und die Änderungen vollständig umsetzen. LoLBench hofft, die Bewertung der Agentenfähigkeiten von der Generierung von Code hin zur Unterstützung der kontinuierlichen Evolution von Software voranzutreiben, indem die Lieferergebnisse zum Maßstab für die Prüfung der Agentenfähigkeiten gemacht werden.
Referenz: PEP 617: https://peps.python.org/pep-0617/
Dieser Artikel stammt aus dem WeChat-öffentlichen Konto „Xinzhiyuan“, Autor: Xinzhiyuan; Redakteur: LRST