同志們,Anthropic 又來捲價格了。這次輪到 Claude 家族裡最便宜的 Haiku。
10月7日,Anthropic 正式發布 Claude Haiku 5.5 ,號稱自家迄今速度最快、能力最強、價格最低的小模型。
最誇張的是價格,每百萬輸入Token 最低只要 0.1美元,相比上代直接降價90%。
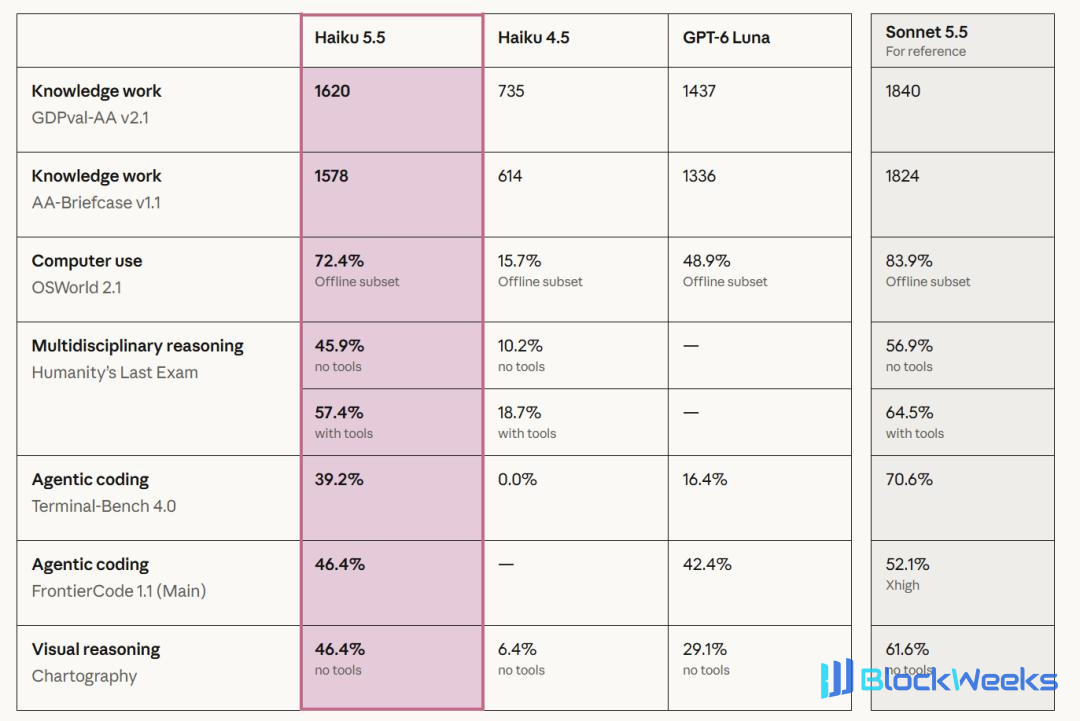
性能也沒落下。按照 Anthropic 公布的測試結果,Haiku 5.5 在計算機操作、知識工作、Agent 編程等多個基準上超過 OpenAI 的 GPT-6 Luna,部分成績甚至拉開了不小的差距。
而且,Haiku 5.5 還引入了可調節的推理強度,支持 100萬Token 上下文窗口和最高 12.8萬Token 輸出。
至此,Anthropic 在短短 15 天裡完成了 Claude 5.5 全家桶的更新:9 月 22 日 Opus 5.5 登場,9 月 28 日 Sonnet 5.5 發布,如今 Haiku 5.5 也正式加入。
這次,Anthropic 把重點放在了那些調用量巨大、對價格極其敏感的 AI 任務上。
多項成績超過 GPT-6 Luna,計算機操作成功率 72.4%
按照 Anthropic 公布的 Benchmark 成績,Haiku 5.5 相比上一代實現了大幅提升,在部分測試中還取得了比 GPT-6 Luna 更好的成績。
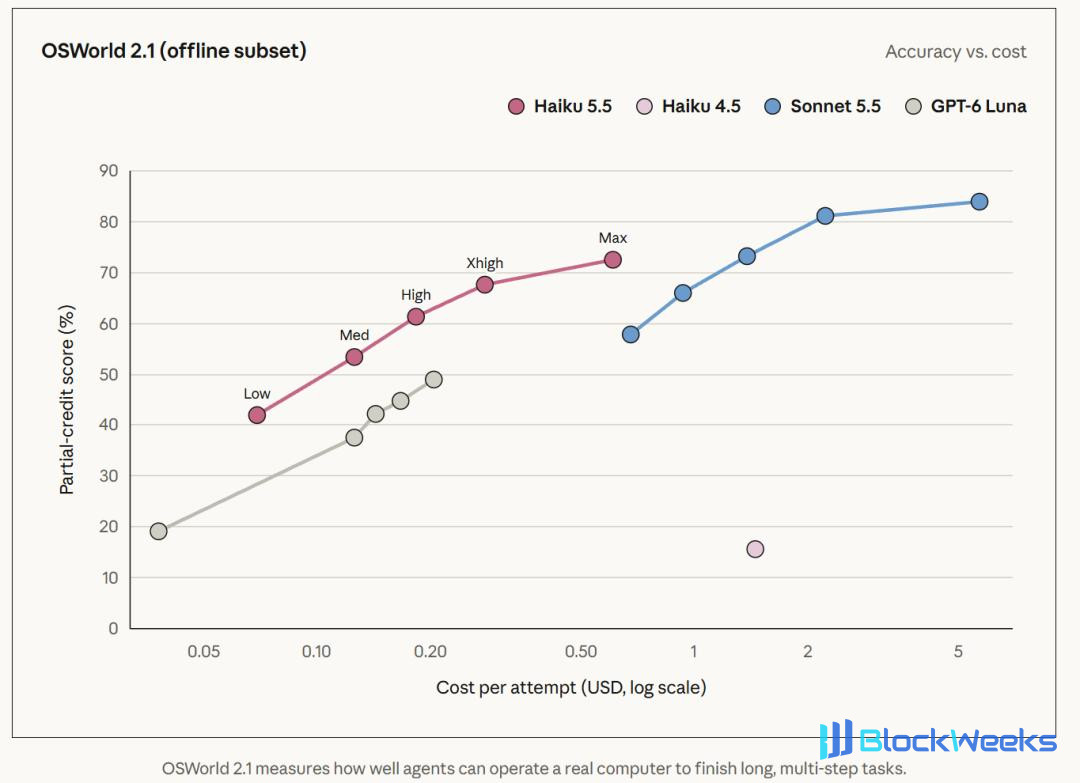
其中最顯眼的成績來自 OSWorld。這是一項衡量 AI Agent 操作真實計算機能力的測試,要求模型完成跨應用、多步驟的操作任務。
在 OSWorld 2.1 離線任務子集上,Haiku 5.5 取得 72.4% 的成功率,上一代 Haiku 4.5 只有 15.7%,GPT-6 Luna 則為 48.9%。
知識工作方面,Haiku 5.5 在 GDPval-AA v2.1 中取得 1620 分,超過 GPT-6 Luna的1437分。Agent 編程測試 Terminal-Bench 4.0 中,兩者成績分別為 39.2% 和 16.4%。
不過,這些數據還有一個重要細節。Haiku 5.5 的最高 Benchmark 成績,往往需要付出更多推理計算。
Haiku 5.5 首次在 Haiku 系列中引入可調節推理強度,開發者可以通過 effort 參數控制模型投入多少計算資源。
媒體 VentureBeat 注意到,在 Anthropic 公布的 Terminal-Bench 測試中, 39.2% 的成績對應最大推理強度。切換至中等推理強度後,成績降至約 20% ,而中等強度正是 Haiku 5.5 的默認設置。
第三方評測機構 Artificial Analysis 也觀察到了類似現象。在其 Intelligence Index 評測中,Haiku 5.5 最大推理強度獲得 43 分,中等推理強度為 34 分。同一評測下,平均每項任務成本分別約為 0.21 美元和 0.05 美元。
也就是說,模型可以通過增加推理預算換取更好的任務表現,但實際花費也可能明顯增加。
Artificial Analysis 在自己的 Terminal-Bench 4.0 測試中,測得最大推理強度 33% 、中等強度 15% 的成績。由於評測設置不同,這組數字與 Anthropic 官方結果存在差異。
這也是為什麼看待小模型性能時,需要同時考慮推理強度、任務完成率和實際成本。
在更複雜的 Agent 編程任務上,Sonnet 5.5 依然具有明顯優勢:Terminal-Bench 4.0 成績達到 70.6%。
Anthropic 也明確表示,Sonnet 和 Opus 仍然更適合複雜的 Agent 編程任務,Haiku 的優勢集中在高頻、範圍明確的工作中。
價格直接砍到一折,和 GPT-6 Luna 正面競爭
如果說性能提升讓 Haiku 5.5 有了競爭力,那麼價格可能才是此次發布最重要的看點。Anthropic 為新模型設計了兩檔 API 價格。

對於提示長度不超過 10 萬 Token 的請求,Haiku 5.5 的輸入、輸出單價都比上一代降低 90% 。超過這個門檻,價格仍比 Haiku 4.5 低 50%。
Anthropic 表示,上一代 Haiku 約 90% 的請求都處於 10 萬 Token 以內。結合不同請求長度和 Token 消耗變化,公司預計 Haiku 5.5 完成同類任務的平均成本下降約 75%。
這裡還有一個容易忽略的細節—— Haiku 5.5 換用了新的 Tokenizer 。根據官方開發者文檔,同一段文本在新模型中產生的 Token 數量,可能比 Haiku 4.5 多約 30% ,具體增幅取決於內容。因此,API 單價下降 90% ,並不代表每項任務的帳單都能減少 90% 。
另一個值得關注的對手是 GPT-6 Luna 。OpenAI 給出的 Luna 基礎定價同樣為每百萬輸入 Token 0.1 美元、輸出 0.5 美元,緩存讀取價格也與 Haiku 5.5 的低價檔一致。
不過,兩家公司的長上下文計費門檻存在明顯差異。
Haiku 5.5 在提示超過 10 萬 Token 後進入更高價格檔;GPT-6 Luna 則在輸入超過 27.2 萬 Token 後才觸發長上下文加價。這意味著,在 10 萬至 27.2 萬 Token 之間的請求中,Luna 的單位 Token 價格具有優勢。
至於最終完成一項任務哪款模型更省錢,還需要結合實際 Token 用量、推理預算和任務成功率判斷。
放到整個市場來看,Anthropic 也在向其他低價模型施加壓力。
VentureBeat 列出的同期 API 價格顯示,Google Gemini 3.5 Flash-Lite 每百萬輸入 Token 價格為 0.3 美元、輸出 2.5 美元;Gemini 3.8 Flash 分別為 0.75 美元和 3.75 美元。
當然,不同模型的能力定位、緩存策略和任務表現各不相同,這些數字首先反映的是 API 價格競爭。
小模型價格戰,正在進一步升級。
一週 800 萬次調用,企業開始讓小模型給大模型打工
Haiku 5.5 到底適合幹什麼?
Anthropic 給出的場景包括文檔摘要、信息分類、數據庫查詢、上下文壓縮,以及在複雜 Agent 工作流中擔任 Subagent。
這背後有一個很現實的問題:如今的 Agent 越來越複雜,一項任務往往需要多次調用模型。如果每個步驟都交給大模型處理,成本會快速累積。
金融 AI 公司 Rogo 提供了一個例子。在它的工作流中,一個能力更強的大模型負責製作財務演示文稿。處理其中某張幻燈片時,Haiku 5.5 Subagent 進入企業 10-K 年報,找到需要的業務收入數據,再把結果交給主模型。
對這種任務,模型需要快速、準確地完成信息查找和提取。Rogo 認為,Haiku 5.5 在準確率、速度和價格之間達到了適合大量重複調用的平衡。
企業內容管理平台 Box 也給出了早期測試結果。相比 Haiku 4.5,Haiku 5.5 的內部評測成績提高 11 分,延遲下降約 50%。
Box 表示,這讓新模型適合成本報告、財務摘要、週期性審查等需要規模化運行的分析工作。不過,Box 沒有公開完整的評測標準。
Asana 的測試則覆蓋 Bug 分類、項目建立、大型項目組合搜索等 Agent 任務。根據其披露的結果,相比當前使用的模型,Haiku 5.5 讓任務完成延遲降低超過 30% ,單輪 Agent 推理速度最高提升 2.5 倍。
另一個更能體現成本價值的例子來自 AlphaSense。這家公司的Ask in Document 功能每週需要處理約 800 萬次調用,主要回答針對一份或幾份文檔的具體問題。
在 400 個測試查詢中,Haiku 5.5 的內部評測得分達到 0.84,而 Haiku 4.5 為 0.76。
如果一款模型每週要被調用數百萬次,哪怕每次只節省很少的錢,長期累積下來的成本變化也可能相當可觀。
這些數據來自 Anthropic 披露的早期客戶反饋,具體工作負載、對照模型及評價標準並不完全一致,還需要更多獨立測試。
Sonnet 跟著降價,Claude 5.5 全家桶開始拼成本
除了 Haiku 5.5,Anthropic 還同步調整了 Sonnet 5.5 的定價。從 10 月 7 日起,Sonnet 5.5 的緩存讀取費用降低 50%,從每百萬 Token 0.2 美元降至 0.1 美元。
Anthropic 預計,這項調整可以讓多數 Agent 工作負載的成本再降低約 20%,實際降幅取決於應用重複使用緩存上下文的程度。
對於需要反覆讀取長對話歷史、工具說明和任務上下文的 Agent 來說,緩存成本會直接影響系統的長期運行開銷。
Anthropic 同時為 Claude Max 和 Team 訂閱用戶推出每月 API 額度:Max 5x 用戶 100 美元,Max 20x 用戶 200 美元,Team 用戶共享最高 500 美元。
這些額度可用於 Claude 平台上的模型調用,鼓勵更多訂閱用戶嘗試構建自己的 Agent 和應用。
開發者方面,Haiku 5.5 已通過 Anthropic API、Amazon Bedrock、Google Cloud 和 Microsoft Azure 等平台提供服務,API 模型 ID 為 claude-haiku-5-5。
Anthropic 也更新了 Python 和 TypeScript SDK ,新增處於 Beta 階段的瀏覽器操作與計算機操作支持。
至此,Claude 5.5 系列的產品分工已經相當清楚。
Opus 5.5 負責高難度、複雜推理任務,Sonnet 5.5 覆蓋日常複雜工作與編程, Haiku 5.5 則主攻調用量大、成本敏感、要求快速響應的任務。
從 9 月 22 日到 10 月 7 日,Anthropic 用了 15 天完成這一輪產品更新,三個型號都在強調性能和成本效率。
Haiku 5.5 的發布,也讓一個趨勢更加明顯。隨著 Agent 逐漸從演示走向實際應用,開發者必須考慮整套系統的調用成本。一次任務裡哪些步驟需要更強的模型、哪些可以交給小模型,以及不同模型之間如何分配工作,都會影響最終的商業可行性。
對 Anthropic 來說,Haiku 5.5 最有吸引力的地方,或許就在這裡:它讓更多原本因調用成本過高而難以規模化的任務,開始具備經濟上的可行性。
小模型的競爭,已經開始深入 Agent 系統的每一個執行環節。
參考資料
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
本文來自微信公眾號 “機器之心”(ID:almosthuman2014),編輯:勺嘴鷸