如今Agent已經能熟練調用工具、修改檔案、執行測試,但面對一個長期演進的大型軟體系統,它能否從一份新需求出發,交付完整功能?
產品經理提出新需求,開發者拿到的往往不是檔案清單或函式簽名。需要先理解約束,追蹤模組依賴,再判斷改哪裡、怎麼改、怎樣證明改對了。這些分析影響後續交付。
復旦大學、香港城市大學、香港中文大學等機構提出LoLBench,把Agent放進平均約240萬行原始碼的軟體系統,評估從功能提案到模組交付的完整過程,檢驗把需求落到系統中的感知能力,以及完成跨模組修改的實現能力。
論文連結:https://arxiv.org/abs/2609.37143
資料集:https://huggingface.co/datasets/lolbench26/LoLBench
實驗暴露出關鍵斷點:Agent可能改對局部,卻漏掉其他模組中必須同步的改動。即使補充實現指引,多數任務仍未解決,從理解需求到完成交付仍有很長距離。
重新定義長程程式碼任務
什麼樣的長程程式碼任務,才有實際工程價值?
「長程」不能只看耗時、輪數或Token消耗。例如讓Agent每分鐘輸出一個數字,從1數到1000,雖然耗時很久,卻只需簡單迴圈。SWE-bench類局部Bug修復的任務,也不能覆蓋從需求分析到模組交付的挑戰。
LoLBench關注的長程程式碼任務,是面向複雜系統的模組開發。接到新需求後,開發者會反覆分析:哪些行為必須實現?已有架構能否支持?哪些依賴會受影響?怎樣驗證?LoLBench把這部分藏在開發者腦子裡的分析也納入評估,讓Agent自行完成從用戶意圖到實現方案的推導。
這類任務同時具有感知複雜性和實現複雜性:前者是讀懂提案、識別隱含約束和跨模組依賴、推導修改範圍與實現規範(specification)的難度;後者是將規範轉成正確的跨檔案修改,並通過測試和修復避免已有功能被破壞的難度。
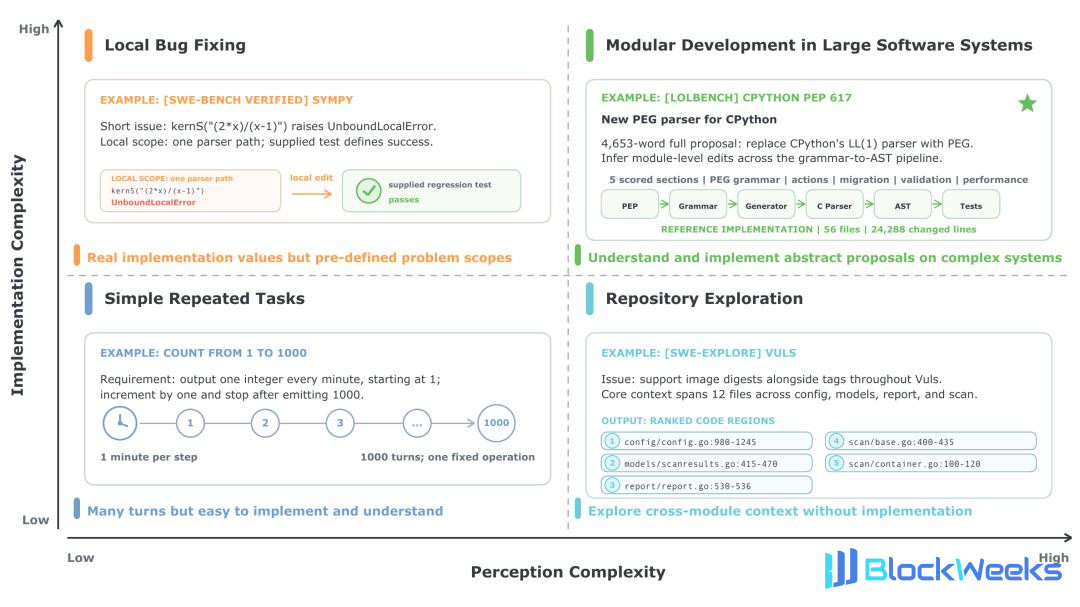
圖1 感知複雜性與實現複雜性的比較。
LoLBench如何同時評估兩類複雜性
從功能提案推導實現規範
LoLBench從社群功能提案(Enhancement Proposal)及對應的已合併PR中選取100項任務,覆蓋29個系統、8種語言和5個領域。
Agent僅獲提案與實現前程式碼倉,提案平均約5000個英文單詞。評測在斷網的Docker環境中開展,防止Agent檢索上游實現。
例如,PEP 617[1]提議用PEG替換CPython的LL(1)解析器,實現時需貫通語法定義、解析器生成、抽象語法樹與錯誤報告。Agent必須識別整條實現鏈路。
感知複雜性方面,LoLBench參考實現的目標類名在提案中的平均提及率僅7.3%,不到SWE-bench Verified(15.9%)的一半,也不到FeatureBench(38.7%)的五分之一。Agent須自行推測需求與程式碼的聯繫。
把規範落實為工程交付
實現複雜性方面,LoLBench倉庫平均約240萬行原始碼,約為SWE-bench Verified的9.4倍、FeatureBench的4.9倍;實現平均改動5499行,後兩者分別為38行和2050行。每項任務平均改動64.9個檔案、40.1個類和195.9個函式;檔案數分別為兩者的25倍和4.2倍。跨模組協同與驗證更難。

表1 LoLBench與現有程式碼任務評測集的對比。
LoLBench通過兩類測試驗證交付正確性:新增功能測試(F2P)要求實現前失敗、實現後通過,F2P通過公開介面檢驗行為,允許不同內部實現。回歸測試(P2P)要求前後均通過。
在專案原有的測試基礎上,研究團隊構造遺漏功能、篡改需求等錯誤實現作為變異體,補充測試用例識別漏檢錯誤,並提高參考補丁的測試覆蓋率。
增強後,1688個變異體的檢出率從約61%升至96%,F2P按任務平均的行覆蓋率從約60%升至79%。
28種Agent組合的表現與瓶頸
換模型或腳手架,Agent最高解決率僅14%
研究團隊評估6個前沿模型與5個腳手架的28個可用組合,單任務限時6小時。Opus 5搭配Claude Code或mini-SWE-agent均以14%的解決率並列最高,全部組合的中位數僅2%。

表2 論文中的主要實驗結果
同用Opus 5,mini-SWE-agent與Claude Code解決率相同,前者耗時為後者的3.2倍、生成Token為5倍,更多消耗未換來更高解決率。
大量互動與Token花在程式碼定位上
從Token消耗來看,按Agent平均,定位階段占非快取輸入Token的52.4%、生成Token的45.4%。從Agent互動輪數來看,定位階段的互動輪數也顯著多於其他階段。

圖2 各階段的平均互動輪數。
對照參考實作修改的既有檔案和函式,全部28組Agent的檔案修改精確率為38.0%至80.4%,召回率為30.3%至65.0%;函式修改精確率為54.2%至65.6%,召回率為20.8%至53.4%。程式碼定位準確率低,覆蓋仍不完整。
補充修改指引後,Agent仍難以完整交付
研究團隊保留原功能提案,額外提供參考實作匯出的修改檔案樹與API實作規範,幫助Agent確定修改範圍。Opus 5+Claude Code的解決率從14%升至34%,GPT-5.6 Sol+Codex從3%升至25%,
DeepSeek
V4 Flash+OpenCode從1%升至17%。

表3 補充修改檔案樹與API實作規範後的實驗結果
補充修改指引能緩解感知負擔,但最佳組合仍有66%的任務未解決。Agent仍需協調模組、實作介面並通過驗證,這提示大型系統的實作複雜性同樣很高。
從程式碼生成走向大型軟體系統演進
這些結果為Agent研發提供了可檢驗的方向:倉庫檢索能否覆蓋關鍵依賴,編碼前的實作規範是否完整,驗證能否及時發現跨模組遺漏。
軟體工程的價值,在於使用者需求能否被可靠兌現。Agent需要理解變更為何發生、如何影響系統,並把變化完整實作。LoLBench希望推動Agent能力評估從生成程式碼走向支持軟體持續演進,讓交付結果成為檢驗Agent能力的尺度。
參考資料:PEP 617:https://peps.python.org/pep-0617/
本文來自微信公眾號「新智元」,作者:新智元;編輯:LRST