Сегодняшние агенты уже умеют уверенно вызывать инструменты, изменять файлы и запускать тесты, но способны ли они, столкнувшись с крупной программной системой, развивавшейся долгое время, начать с нового требования и поставить законченную функциональность?
Когда продакт-менеджер выдвигает новое требование, разработчики часто получают вовсе не список файлов или сигнатуры функций. Сначала им нужно понять ограничения, проследить зависимости модулей, а затем определить, где вносить изменения, как их вносить и как доказать, что изменения корректны. Этот анализ влияет на последующую поставку.
Фуданьский университет, Городской университет Гонконга, Китайский университет Гонконга и другие учреждения предлагают LoLBench, который помещает агентов в программные системы со средним объёмом около 2,4 млн строк исходного кода, оценивает полный процесс от выдвижения функциональности до поставки модуля и проверяет способность восприятия привязывать требования к системе, а также способность реализации выполнять межмодульные изменения.
Ссылка на статью: https://arxiv.org/abs/2609.37143
Датасет: https://huggingface.co/datasets/lolbench26/LoLBench
Эксперименты выявляют ключевую точку разрыва: агент может внести корректное локальное изменение, но упустить изменения в других модулях, которые необходимо синхронизировать. Даже при дополнительных указаниях по реализации большинство задач остаются нерешёнными, и от понимания требований до завершения поставки всё ещё остаётся долгий путь.
Переосмысление долгосрочных задач по коду
Какая долгосрочная задача по коду имеет реальную инженерную ценность?
«Долгосрочность» нельзя оценивать только по затраченному времени, числу раундов или расходу токенов. Например, если попросить агента выводить по одному числу в минуту, считая от 1 до 1000, это займёт много времени, но потребует лишь простого цикла. Задачи локального исправления ошибок в стиле SWE-bench также не могут охватить вызов от анализа требований до поставки модуля.
Долгосрочные задачи по коду, на которых фокусируется LoLBench, — это разработка модулей для сложных систем. Получив новое требование, разработчики многократно анализируют: какое поведение должно быть реализовано? Способна ли существующая архитектура его поддержать? Какие зависимости будут затронуты? Как проверить? LoLBench также включает этот анализ, скрытый в головах разработчиков, в оценку, позволяя агенту самостоятельно вывести план реализации из намерения пользователя.
Такие задачи одновременно обладают сложностью восприятия и сложностью реализации: первая — это трудность понимания предложения, выявления неявных ограничений и межмодульных зависимостей, вывода области изменений и спецификации реализации; вторая — это трудность преобразования спецификации в корректные межфайловые изменения и, посредством тестирования и исправления, предотвращения нарушения существующей функциональности.
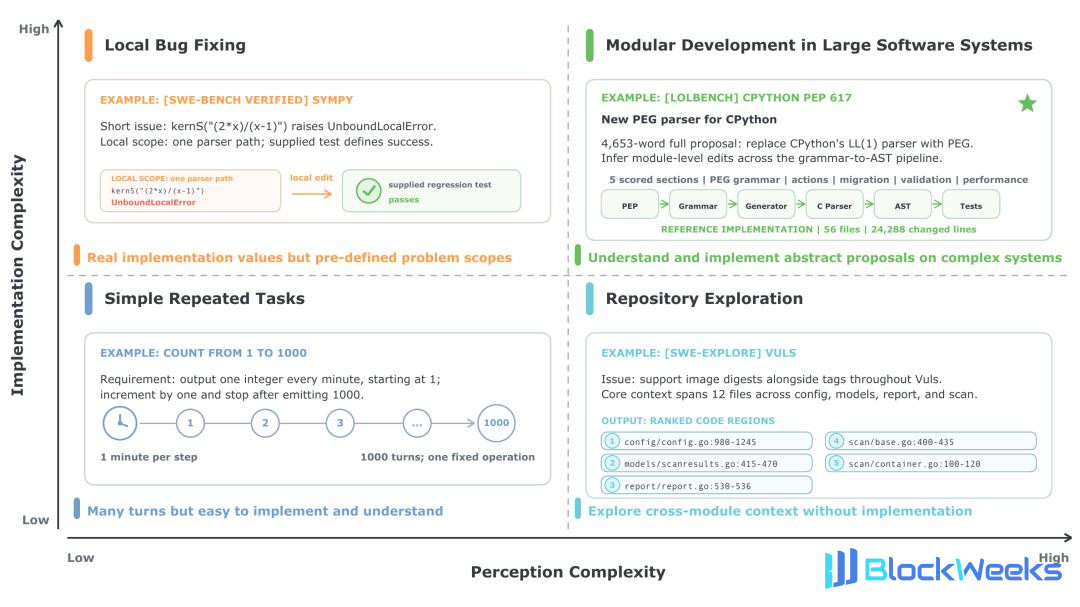
Рисунок 1. Сравнение сложности восприятия и сложности реализации.
Как LoLBench оценивает оба типа сложности одновременно
Вывод спецификаций реализации из предложений о функциональности
LoLBench отбирает 100 задач из предложений по улучшению сообщества и соответствующих им объединённых PR, охватывая 29 систем, 8 языков и 5 предметных областей.
Агент получает только предложение и репозиторий кода до реализации; предложение в среднем содержит около 5000 английских слов. Оценка проводится в офлайн-среде Docker, чтобы агент не мог получить доступ к вышестоящим реализациям.
Например, PEP 617 [1] предлагает заменить LL(1)-парсер CPython на PEG, и реализация требует связывания определений грамматики, генерации парсера, абстрактных синтаксических деревьев и отчётности об ошибках. Агент должен определить всю цепочку реализации.
С точки зрения сложности восприятия, средняя частота упоминания в предложении целевых имён классов в эталонной реализации LoLBench составляет всего 7,3%, что менее половины от SWE-bench Verified (15,9%) и менее одной пятой от FeatureBench (38,7%). Агент должен самостоятельно вывести связь между требованиями и кодом.
Превращение спецификаций в инженерную поставку
С точки зрения сложности реализации, репозитории LoLBench в среднем содержат около 2,4 миллиона строк исходного кода, что примерно в 9,4 раза больше, чем у SWE-bench Verified, и в 4,9 раза больше, чем у FeatureBench; реализации изменяют в среднем 5 499 строк по сравнению с 38 строками и 2 050 строками у последних двух. Каждая задача изменяет в среднем 64,9 файла, 40,1 класса и 195,9 функции; количество файлов в 25 раз и в 4,2 раза больше, чем у двух других соответственно. Межмодульная координация и верификация сложнее.

Таблица 1 Сравнение LoLBench с существующими наборами оценки кодовых задач.
LoLBench проверяет корректность поставки с помощью двух типов тестов: тесты новых функций (F2P) требуют неудачи до реализации и прохождения после реализации; F2P проверяет поведение через публичные интерфейсы и допускает различные внутренние реализации. Регрессионные тесты (P2P) требуют прохождения как до, так и после.
Поверх оригинальных тестов проекта исследовательская группа конструирует ошибочные реализации, такие как отсутствующие функции и подменённые требования, в качестве мутантов, дополняет тестовые случаи для выявления пропущенных ошибок и повышает покрытие тестами эталонных патчей.
После улучшения доля обнаружения 1 688 мутантов возрастает с примерно 61% до 96%, а среднее построчное покрытие F2P на задачу возрастает с примерно 60% до 79%.
Производительность и узкие места 28 комбинаций Агентов
При смене моделей или скаффолдов максимальная доля решённых задач Агентом составляет всего 14%
Исследовательская группа оценивает 28 доступных комбинаций 6 передовых моделей и 5 скаффолдов с ограничением времени 6 часов на задачу. Opus 5 в паре с Claude Code или mini-SWE-agent делят первое место по максимальной доле решённых задач — 14%, а медиана по всем комбинациям составляет всего 2%.

Таблица 2 Основные экспериментальные результаты в статье
При использовании того же Opus 5 mini-SWE-agent и Claude Code достигли одинаковой доли решённых задач, но первый потратил в 3,2 раза больше времени, чем второй, и сгенерировал в 5 раз больше токенов; большее потребление не принесло более высокой доли решённых задач.
Большое количество взаимодействий и токенов тратится на локализацию кода
С точки зрения потребления токенов, в среднем по агентам этап локализации составил 52,4% некэшированных входных токенов и 45,4% сгенерированных токенов. С точки зрения количества раундов взаимодействия агента этап локализации также имел значительно больше раундов взаимодействия, чем другие этапы.

Рисунок 2 Среднее количество раундов взаимодействия на каждом этапе.
Для существующих файлов и функций, изменённых относительно эталонной реализации, во всех 28 группах агентов точность модификации файлов составила от 38,0% до 80,4%, а полнота — от 30,3% до 65,0%; точность модификации функций составила от 54,2% до 65,6%, а полнота — от 20,8% до 53,4%. Точность локализации кода низкая, а охват остаётся неполным.
Даже после дополнения руководства по модификации агенты по-прежнему с трудом справляются с задачей полностью
Исследовательская группа сохранила исходное предложение функций и дополнительно предоставила дерево файлов модификации, экспортированное из эталонной реализации, и спецификации реализации API, чтобы помочь агентам определить объём модификаций. Доля решённых задач у Opus 5+Claude Code выросла с 14% до 34%, у GPT-5.6 Sol+Codex — с 3% до 25%,
DeepSeek
V4 Flash+OpenCode — с 1% до 17%.

Таблица 3. Результаты экспериментов после дополнения дерева файлов модификации и спецификаций реализации API
Дополнение руководства по модификации может облегчить нагрузку на восприятие, но у лучшей комбинации по-прежнему оставалось 66% нерешённых задач. Агентам всё ещё необходимо координировать модули, реализовывать интерфейсы и проходить валидацию, что говорит о том, что сложность реализации крупных систем также очень высока.
От генерации кода к эволюции крупных программных систем
Эти результаты дают проверяемые направления для исследований и разработки агентов: может ли поиск по репозиторию охватывать ключевые зависимости, являются ли спецификации реализации перед написанием кода полными и может ли валидация своевременно выявлять межмодульные пропуски.
Ценность программной инженерии заключается в том, можно ли надёжно удовлетворить требования пользователей. Агентам необходимо понимать, почему происходят изменения, как они влияют на систему, и полностью реализовывать изменения. LoLBench надеется способствовать переходу оценки возможностей агентов от генерации кода к поддержке непрерывной эволюции программного обеспечения, делая результаты поставки мерилом для проверки возможностей агентов.
Ссылка: PEP 617: https://peps.python.org/pep-0617/
Эта статья взята из публичного аккаунта WeChat «Xinzhiyuan», автор: Xinzhiyuan; редактор: LRST