Impossible, les benchmarks ont vraiment évolué à ce point maintenant ???
Cette fois-ci, il ne s'agit plus de faire des exercices — ils donnent simplement à l'IA un ensemble de conditions expérimentales et la laissent mener ses propres recherches et prédire à l'avance les résultats de véritables expériences en laboratoire humide...
Par exemple, si la même réaction est réalisée dans plusieurs conditions différentes, laquelle produira davantage du produit cible ? Parmi un lot de variants d'anticorps, lequel aura un niveau d'expression plus élevé ?
Les réponses sont d'abord cachées, et une fois que l'IA a rendu sa copie, les résultats réellement mesurés sont comparés à ceux-ci.
Et vous savez quoi, c'est en fait quelque chose qui vaut la peine d'être testé dès maintenant.
Au cours des deux dernières années, l'approche AI for Science est devenue de plus en plus profonde — l'IA peut déjà rechercher de manière autonome dans la littérature, utiliser des logiciels et travailler en continu pendant des heures pour mener à bien une tâche d'analyse.
Naturellement, tout le monde a commencé à passer à l'étape suivante : quel type de capacités de recherche scientifique voulons-nous réellement que l'IA possède ?
La prédiction des résultats en laboratoire humide est l'un des éléments ayant une valeur pratique considérable.
Cela exige que l'IA comprenne l'objectif expérimental et extraie des mécanismes pertinents à partir des connaissances existantes, afin qu'elle puisse mieux aider les chercheurs à identifier les directions de recherche qui méritent d'être explorées plus avant.
Le nouveau benchmark Science Prediction Universe (SPU en abrégé), dirigé et lancé par UniPat AI, a justement remarqué cela.
116 tâches, 4 207 expériences en laboratoire humide, couvrant la chimie, la science des matériaux, la biologie et la médecine. Les conseillers du benchmark et les collaborateurs pour le laboratoire humide viennent également d'universités telles que Stanford, Cornell et Harvard, ainsi que d'institutions de recherche de pointe et d'entreprises de biotechnologie du domaine.
Le modèle suit à chaque fois un système de journée de travail de 8 heures, est équipé d'un H20, puis décide de manière autonome comment utiliser les ressources de recherche et de calcul pour formuler des prédictions expérimentales.
Les résultats ont surpris tout le monde.
Même des modèles puissants comme Opus 5.5 et GPT-6 Astra sont, selon les données, encore très loin de pouvoir réellement réaliser des prédictions...
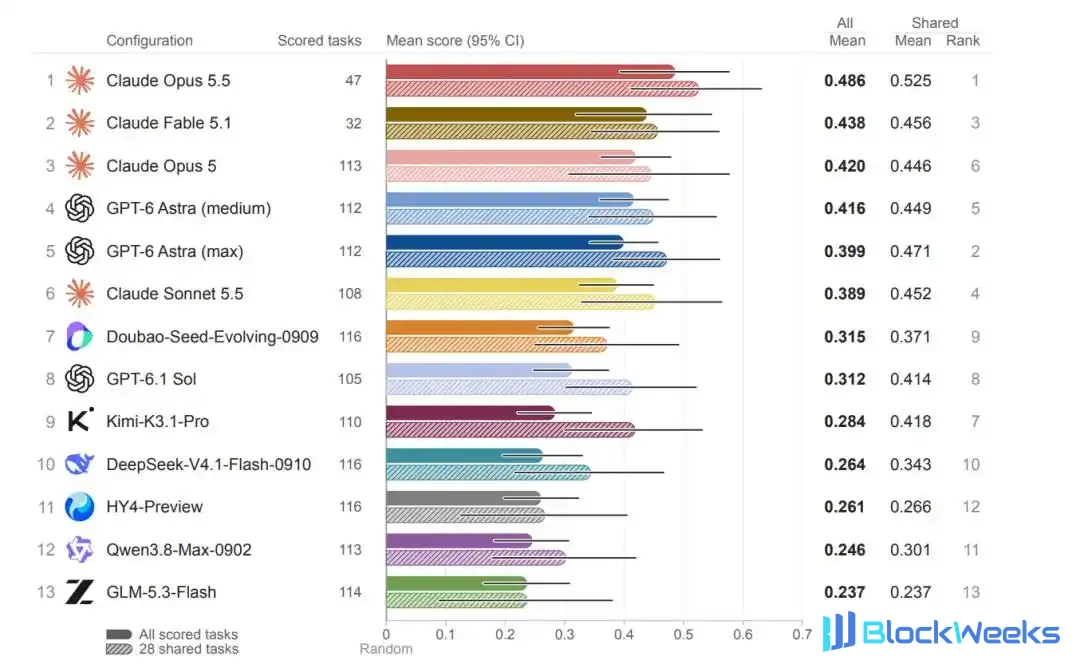
△Scores moyens de chaque configuration sur l'ensemble des tâches notées
Je dois dire que SPU a servi un plat difficile à tous les modèles de recherche.
Ces capacités de recherche qui étaient autrefois invisibles et intangibles sont désormais devenues des valeurs numériques pouvant être évaluées de manière uniforme et étudiées en continu.
Quant à la manière dont le jugement scientifique de l'IA se développe étape par étape, il existe désormais une base plus concrète pour en discuter.
Prédiction en laboratoire humide : un examen à part entière pour les modèles
Revenons à la prédiction en laboratoire humide — d'abord, ce n'est effectivement pas une question nouvelle.
Il y a eu de nombreux moments de ce type dans l'histoire des sciences : un jugement est formulé avant l'expérience, puis on laisse le processus décider — s'il est juste, il reste ; s'il est faux, il est renversé.
La logique spécifique du jugement constitue le goût d'un scientifique.
Avec un goût suffisamment bon et une intuition suffisamment précise, les scientifiques peuvent obtenir de grands résultats plus rapidement tout en économisant de précieuses ressources expérimentales.
Après tout, une seule expérience en laboratoire humide — pour la chimie, il faut préparer les réactifs, définir les conditions de réaction, puis séparer les produits ; pour la biologie, il faut aussi passer par une longue expression protéique... Le coût en temps et le coût des outils sont en eux-mêmes assez élevés, et si les résultats ne sont pas idéaux, il faut recommencer encore et encore pendant plusieurs cycles.
Ainsi, prédire avant de commencer est l'étape la plus précieuse du processus de recherche.

La seule différence est qu'autrefois, cela était fait purement par les scientifiques eux-mêmes, et qu'aujourd'hui, à l'ère de l'IA, les modèles doivent aussi posséder cette capacité, et ils ont également besoin d'une épreuve qui puisse les noter.
Les benchmarks existants ne peuvent toujours pas couvrir entièrement cela. Par exemple, BrainBench permet aux modèles de juger directement les résultats expérimentaux ; ScienceAgentBench se concentre sur l'achèvement de l'analyse sur des données existantes ; et les benchmarks de tâches à long horizon tels que Terminal-Bench 4.0 et Long-Horizon-TB utilisent principalement des tests prédéfinis pour vérifier les sorties des tâches.
SPU est différent de tous ceux-là.
Il met davantage l'accent sur l'évaluation du processus de recherche autonome de l'IA conjointement avec la prédiction des résultats en laboratoire humide, impliquant à la fois la performance de prédiction et la capacité à utiliser des outils scientifiques et à exécuter des tâches à long horizon.

△Le graphique a été généré par l'IA
Ce type de jugement a également été organisé par SPU en tâches claires.
100 tâches publiques ont été respectivement tirées de 85 articles récemment publiés. Des experts du domaine ont organisé les options candidates, les matériaux, les conditions et les méthodes de mesure issus de la recherche, en conservant des résultats quantitatifs complets comme base de notation.
En outre, 16 tâches privées proviennent de quatre groupes d'expériences en laboratoire humide collaboratives non publiées, impliquant des nanobodies VHH, des conditions de réaction, des électrolytes et des variants de Magrolimab.
Au total, 32 sous-domaines et 4 207 expériences, parmi lesquelles les recherches publiques fournissent des sources de tâches interdisciplinaires, les résultats mesurés sont cachés aux modèles, et les expériences non publiées ajoutent des tests indépendants des réponses dans les articles publics.
Dans une certaine mesure, cela peut empêcher les modèles d'avoir déjà vu les questions à l'avance.

△Couverture et sources des tâches de SPU
Le processus de sélection des questions est également assez particulier.
Les experts donnent la priorité aux études dont les mesures sont complètes et les conditions claires ; les questions simples qui peuvent être classées selon une seule tendance sont directement éliminées, et les questions dont les valeurs sont trop proches sont également considérées comme ayant peu de valeur de référence.
Les questions qui restent finalement sont toutes plus difficiles et plus discriminantes.
Pendant le processus de prédiction spécifique, le modèle est tenu de fonctionner pendant huit heures à chaque fois, équipé d'un CPU à 8 cœurs, de 16 GiB de mémoire et d'un H20, tout en étant autorisé à effectuer des recherches en ligne et à installer des logiciels de recherche scientifique.
Pendant cette période, le modèle collectera lui-même des preuves, choisira des méthodes de calcul et soumettra finalement le classement prédit du plus bas au plus élevé pour chaque groupe de comparaison.
Pour éviter toute contamination de la mémoire, le processus de notation est également mené de bout en bout dans un conteneur indépendant et hors ligne ; il est interdit à l'IA de récupérer les résultats de recherche originaux, et les sorties des outils sont automatiquement analysées afin d'identifier des identifiants tels que le DOI et le titre de l'article source.
Enfin, le système utilise le coefficient de corrélation de Spearman pour comparer le classement prédit avec le classement mesuré.
Plus le coefficient est proche de 1, plus le classement est proche des résultats expérimentaux.

△Le processus d'évaluation de SPU
Fait intéressant, SPU prête également attention à de nombreux détails que les tests de référence n'ont pas pris en compte.
Par exemple, concernant le score final, SPU se demande s'il pourrait être dû à la chance, au cas où ce serait un coup de chance.
Il génère donc en outre 4 000 classements aléatoires pour chaque question, utilise le 95e percentile comme seuil de niveau aléatoire, et vérifie si la soumission du modèle dépasse significativement cette référence. Différentes tâches ont également des bases de référence correspondantes.
La conception de l'ensemble du SPU peut être qualifiée de scientifiquement rigoureuse.
Le modèle doit, étape par étape en son sein, juger par lui-même ce qui mérite d'être calculé et soumettre sa prédiction finale.
Cette conception aide non seulement à mesurer la capacité actuelle de prédiction en laboratoire humide de l'IA, mais indique également la direction aux équipes de recherche ultérieures pour améliorer continuellement les expériences à l'aide de métriques unifiées.
Cela dit, nous pouvons maintenant jeter un coup d'œil ensemble aux bulletins de notes de la première vague de modèles de pointe. Les détails méritent vraiment d'être discutés séparément.
Le nouveau test fait s'effondrer collectivement les modèles de pointe
Le premier cycle d'évaluation systématique de SPU couvre 12 modèles de pointe et 13 configurations. Les configurations ici désignent le modèle, l'intensité de raisonnement et le cadre de modèle utilisés.
Tout d'abord, parlons des résultats globaux.
En une phrase : aucun d'entre eux n'est bon.
Sur l'ensemble des tâches notées, le score moyen le plus élevé a été obtenu par Claude Opus 5.5, avec 0,486 point. Mais même pour lui, seulement la moitié des tâches ont dépassé le niveau aléatoire.
Parmi les 13 configurations, c'est presque toujours le cas ; la proportion de tâches dépassant le seuil de niveau aléatoire n'est que de 34 % à 52 %.
En d'autres termes, tous les modèles présentés ont encore un long chemin à parcourir avant une prédiction en laboratoire humide véritablement fiable.

△Analyse comparative des comportements du groupe de tête et du groupe de queue
Cependant, il existe également des différences entre les modèles, et la performance moyenne peut être divisée en deux niveaux :
le groupe de tête (6 modèles) et le groupe de queue (7 modèles).
Dans les comparaisons sur des questions identiques, le groupe de tête est en moyenne encore environ 0,15 point plus élevé que les sept autres.
Un autre détail mérite d'être noté. Environ 9 % des tâches du groupe de tête ont obtenu un score inférieur à 0, tandis que pour les sept autres configurations, cette proportion peut atteindre 22 %.
Ici, 0 désigne le score moyen d'un classement valide aléatoire ; un score négatif signifie que la prédiction est corrélée négativement avec le classement réel.
D'où vient exactement l'écart ? L'équipe de recherche a creusé d'un cran supplémentaire.
Ils ont d'abord combiné les prédictions d'autres modèles sur la même question en un classement de référence, puis ont apparié les expériences deux à deux, les ont comparées avec les résultats mesurés, et ont vérifié si chaque modèle les classait individuellement correctement.
Sur les paires d'expériences où le classement de référence était correct, le groupe de tête les a classées correctement 86 % du temps, tandis que les sept autres configurations atteignaient 78 % ; pour les paires d'expériences où le classement de référence était erroné, les deux groupes les ont classées indépendamment correctement dans environ 30 % des cas.
Donc en fait, une partie de l'avantage du groupe de tête se reflète précisément dans les cas où les prédictions sont conjointement correctes ; dans cette partie, le groupe de tête est toujours plus stable.

Quant à savoir pourquoi le modèle s'écarte du jugement correct, les enregistrements d'exécution contiennent des indices plus précis.
Prenons l'exemple de la tâche de solution. Pour une même réaction de polymérisation, 12 solvants ont été changés successivement, et la tâche exigeait de classer selon la masse du polymère finalement séparé.
Opus 5.5 a obtenu un score de 0,874, tandis que Qwen3.8 a obtenu -0,126. Les 12 conditions de solvant candidates ont été appariées deux à deux, pour un total de 66 paires ; le premier a classé correctement 56 paires, et le second a classé correctement 30 paires.

△Deux exécutions d'Opus et de Qwen sur la même tâche
L'analyse a révélé que cela est dû au fait que les deux différaient dans les facteurs sur lesquels ils se concentraient dès le départ :
Qwen3.8 classait principalement en fonction de la quantité d'éthylène que le solvant peut dissoudre, tandis qu'Opus 5.5 accordait davantage d'attention à la miscibilité des matières premières et à la compatibilité du catalyseur dans le solvant.
Bien que Qwen3.8 ait également découvert ce problème au cours du processus de calcul, il n'a finalement pas réussi à modifier directement la base de classement finalement adoptée par le modèle.
Par conséquent, l'étape où les erreurs de prédiction sont les plus susceptibles de se produire est celle du choix de la base de jugement. Le modèle doit également apprendre à ajuster en temps réel la méthode de classement en fonction des indices, afin que ces découvertes puissent réellement influencer la réponse.
Décomposées, ces différences varient également selon la discipline et la tâche spécifiques.
Parmi les résultats notés pour chaque discipline dans les tâches publiques, le score moyen le plus élevé en chimie était celui d'Opus 5.5, en science des matériaux celui de Fable 5.1, en biologie celui de GPT-6 Astra Medium, et en médecine celui d'Opus 5.
P.-S. Fable 5.1 et Opus 5.5 ont manifesté un comportement de refus de répondre.

△Scores de chaque modèle dans les quatre disciplines
Donc si vous préparez à faire participer l'IA à un certain type de recherche, vous pourriez d'abord trouver une tâche connexe et la tester avec SPU, et ne procéder à des expériences formelles qu'après avoir confirmé que le modèle est réellement applicable.
Les résultats des tâches privées rendent ce point encore plus concret.
Parmi les 13 configurations, 12 avaient des scores moyens significativement supérieurs au classement aléatoire, et aucune différence évidente n'a été détectée entre les configurations. En revanche, la variation apportée par les différentes tâches était particulièrement frappante.
Pour un même lot d'électrolytes, lors de la prédiction de la conductivité ionique, les coefficients de corrélation de rang des 13 configurations étaient concentrés dans la plage de 0,89 à 0,95 ; en passant à la fenêtre électrochimique, les scores des 12 configurations ayant obtenu une note allaient de -0,55 à 0,07, aucun ne dépassant le seuil du niveau aléatoire.
Le modèle n'a pas changé, mais dès que la cible de mesure a changé, la distribution des scores a clairement changé elle aussi.
Ainsi, la prochaine fois que vous évaluerez un modèle, dire simplement qu'il est bon en chimie n'est pas assez précis ; il faut aussi voir quelle cible de mesure spécifique et quelles conditions expérimentales il affronte.

△Performance de prédiction de chaque modèle sur les 16 tâches privées
Voici une autre chose assez contre-intuitive :
D'une manière générale, donner au modèle plus de temps et une intensité de raisonnement plus élevée devrait faire continuer à monter le score, non ?
Tout le monde pense généralement ainsi, et tout le monde fait ainsi.
Mais devinez quoi ? Une fois les résultats SPU sortis, ils nous ont directement giflés—
Sous les mêmes 8 heures de calcul, l'équipe de recherche a ajusté GPT-6 Astra d'une intensité de raisonnement moyenne à la plus élevée. Le temps d'exécution médian à l'intensité la plus élevée est passé à 4,8 fois, et le coût API médian a également augmenté à 5,3 fois.
Mais le score de prédiction... n'a presque pas bougé du tout.
Hein ? L'équipe de recherche est même retournée spécifiquement consulter les enregistrements d'exécution du modèle.
Et là, waouh, sur les 79 tâches terminées, GPT-6 Astra à l'intensité de raisonnement la plus élevée avait généralement déjà donné une réponse au médian de 26 % de l'exécution.
Le modèle n'est pas resté inactif par la suite non plus ; il a continué à calculer et à réviser, mais il s'agissait là de réglages fins qui ne se sont pas traduits par des différences dans les résultats.
En d'autres termes, une intensité de raisonnement plus élevée n'améliore pas nécessairement les résultats.

△Investissement et performance de GPT-6 Astra sous deux intensités de raisonnement
Ce phénomène sert également de rappel pour l'allocation des ressources des modèles : si vous voulez ajouter de la puissance de calcul, ne vous précipitez pas aveuglément—cela prend du temps, demande beaucoup d'efforts et peut même ne pas être rentable.
Au lieu de cela, vous pouvez examiner les enregistrements d'exécution plus attentivement, d'abord bien comprendre à quel jugement correspond réellement la nouvelle preuve ajoutée, puis renforcer la puissance de calcul localement de manière ciblée.
En fait, un phénomène similaire apparaît aussi dans l'utilisation d'outils.
À chaque exécution, le nombre médian de catégories de méthodes utilisées par GPT-6 Astra Max est de 4, tandis que pour Medium il est de 1, et pourtant aucune différence significative de score n'a été détectée entre les deux configurations.
La raison est à peu près la même : les bons outils n'ont pas été utilisés là où ils comptaient le plus.
Par exemple, avec l'échantillonnage de Monte Carlo, bien que le modèle appelle cet outil la plupart du temps, cela ne fait qu'ajouter une marge d'erreur au classement final et n'affecte pas directement le résultat lui-même.

△Invocation d'outils de calcul scientifique
Ainsi, en réalité, utiliser davantage d'outils n'est pas aussi efficace que de les utiliser avec précision.
L'utilisation du GPU offre également une perspective intéressante.
Même avec une puissance de calcul GPU suffisante fournie, seules 255 exécutions ont réellement réussi le calcul GPU, moins d'un cinquième.
Les différents modèles et les différentes disciplines varient dans leurs exécutions GPU, de sorte que le simple examen du nombre d'invocations GPU peut difficilement indiquer la capacité de recherche d'un modèle.
Pour juger si la puissance de calcul a aidé, il faut encore voir à quoi elle a servi à calculer, si les résultats du calcul ont aidé à la prédiction, et comment ces résultats ont affecté le classement final.
L'essentiel reste de diriger la puissance de calcul vers les grandeurs physiques pertinentes pour le classement, afin que le modèle puisse réaliser des prédictions plus précisément.

△Statistiques d'utilisation du GPU
En considérant également le coût, le coût API moyen par exécution selon les configurations varie de 0,22 $ à 65,91 $, un écart de pas moins de 300 fois.
Cela signifie que SPU fournit à la fois les performances prédictives et le coût d'invocation, une bonne référence pour les équipes qui se préparent à déployer des modèles de recherche.
Des scores globaux aux trajectoires par question, SPU déploie les différences entre modèles dans chaque détail du jugement scientifique, comme la puissance de calcul et le coût.
Dans quelle mesure les valeurs calculées par l'IA aident réellement à la prédiction ; lorsqu'une prédiction se trompe, quels jugements doivent être réexaminés... tout cela peut être analysé plus en détail en combinant les résultats expérimentaux avec les enregistrements d'exécution.
La prochaine série d'améliorations a ainsi une direction claire à essayer :
Selon SPU, le modèle peut détecter plus rapidement les hypothèses erronées et conserver ou modifier les classements avec plus de justification. Après les modifications, remettez-le dans la même tâche pour voir si les prédictions deviennent plus précises.
Amener « la compréhension du test » dans la salle d'examen du modèle
On peut dire que SPU est hautement cohérent avec les schémas de développement de l'AI4S.
L'évaluation de l'AI4S s'approfondit progressivement dans les étapes expérimentales réelles, et des benchmarks orientés vers l'exécution d'expériences ont également émergé cette année.
Mais au-delà de l'exécution, la prédiction, en tant qu'étape inévitable du processus de recherche et la plus difficile à quantifier, dispose enfin d'un moyen mesurable.
Les bénéfices se reflètent sous deux aspects :
Les chercheurs peuvent ainsi analyser quelles cibles de mesure sont plus faciles à prédire, quelles tâches diffèrent le plus, et comment un jugement erroné se forme. Cela peut économiser des ressources expérimentales coûteuses et précieuses et raccourcir le temps de décision.
Pour le développement de modèles, cela fournit également une référence plus spécifique pour l'amélioration.
À mesure que les types d'expériences augmentent, l'évaluation peut également répondre à des questions plus spécifiques : pour quels matériaux, conditions expérimentales et méthodes de mesure les classements donnés par l'IA sont plus fiables et plus dignes de référence.
Les scientifiques peuvent ainsi accumuler continuellement des progrès autour du même type de questions.

En fait, SPU n'est que la partie émergée de l'iceberg dans la série d'évaluations de travail réel UniPat AI :
- ScienceVision : se concentre sur la manière dont les modèles obtiennent des preuves à partir d'objets scientifiques tridimensionnels et répondent aux questions ;
- PaperBenchX : transforme la recherche publiée en tâches de reproduction d'articles exécutables et vérifiables ;
- SaaS-Bench et EvoCode-Bench : examinent respectivement les processus logiciels réels et le travail de développement lorsque les exigences changent continuellement. ...
Ces travaux couvrent la recherche scientifique, le travail de bureau et le développement logiciel, et partagent tous une préoccupation pour la manière dont l'IA accomplit les tâches après être entrée dans un travail spécifique, et pour la manière dont les résultats sont vérifiés.
Cela reflète également indirectement que UniPat AI possède une vision industrielle unique et un jugement prospectif concernant le mouvement de l'IA vers la pratique de la recherche scientifique et même vers le monde réel.
UniPat AI démontre également un nouveau type de modèle de collaboration en IA :
Des experts du domaine participent à la sélection et à l'examen des tâches, des laboratoires partenaires fournissent des tâches non publiées, et l'équipe du projet organise des expériences de différentes disciplines en tâches d'évaluation unifiées.
Prenons l'exemple de SPU : il est dirigé par UniPat AI, et les institutions des membres du conseil consultatif incluent Stanford, Cornell, Harvard, UIC, l'Université de Pékin, HKUST et FutureHouse. Des collaborateurs de laboratoire humide de Yourui Saishi, Aibotaike, Deep Principle et Enhe Biology ont participé aux travaux expérimentaux associés.
Les connaissances interdisciplinaires et les ressources expérimentales entrent ainsi dans le même processus d'évaluation. SPU ne porte pas seulement la sélection des problèmes, mais présente également la collaboration nécessaire pour organiser les problèmes de recherche scientifique en tâches exécutables.
Actuellement, les 100 tâches publiques liées à SPU sont prévues pour être publiées sous forme de packages de tâches Harbor complets ; les 16 tâches privées resteront privées pour une évaluation contrôlée. Le jeu de données et le code ont tous deux été open source.
Certes, l'IA d'aujourd'hui n'est encore qu'un novice face à ce mécanisme SPU.
Elle peut utiliser des outils à la vitesse de l'éclair, et en 8 heures installer trois ensembles de logiciels, terminer l'exécution de DFT puis lancer Monte Carlo, mais sur le jugement le plus critique, elle n'a pas encore appris à se poser une question : la quantité que je calcule est-elle bien la quantité que l'expérience doit réellement mesurer.
Mais à mesure que ces tâches continuent de s'accumuler, le type de travail de recherche scientifique que l'IA peut entreprendre deviendra également clair.
SPU a mesuré cette distance, et chaque examen ultérieur est un témoignage de l'IA se rapprochant du véritable banc expérimental.
Cet article provient du compte public WeChat « Quantum位 » (ID : QbitAI), auteur : Focus on Frontier Technology