Unmöglich, haben sich Benchmarks wirklich schon auf dieses Niveau entwickelt???
Diesmal geht es nicht mehr darum, Übungsaufgaben zu lösen – sie geben der KI einfach eine Reihe von Versuchsbedingungen und lassen sie selbstständig forschen und die Ergebnisse echter Nasslabor-Experimente im Voraus vorhersagen...
Zum Beispiel: Wenn dieselbe Reaktion unter mehreren verschiedenen Bedingungen durchgeführt wird, welche liefert mehr des Zielprodukts? Bei einer Charge von Antikörpervarianten, welche wird höhere Expressionsniveaus aufweisen?
Die Antworten werden zunächst verborgen, und sobald die KI ihre Arbeit abgibt, werden die tatsächlich gemessenen Ergebnisse damit verglichen.
Und weißt du was, das ist tatsächlich etwas, das es jetzt wert ist, getestet zu werden.
In den vergangenen zwei Jahren ist der Ansatz AI for Science immer tiefer gegangen – KI kann bereits selbstständig die Literatur durchsuchen, Software nutzen und stundenlang ununterbrochen arbeiten, um eine Analyseaufgabe abzuschließen.
Natürlich haben alle begonnen, zum nächsten Schritt überzugehen: Welche Art von wissenschaftlichen Forschungsfähigkeiten wollen wir eigentlich, dass die KI hat?
Die Vorhersage von Nasslabor-Ergebnissen ist einer der Punkte mit erheblichem praktischem Wert.
Sie erfordert, dass die KI das Experimentziel versteht und relevante Mechanismen aus vorhandenem Wissen herausarbeitet, damit sie Forschern besser dabei helfen kann, Forschungsrichtungen zu filtern, die es wert sind, weiter erkundet zu werden.
Der neue Benchmark Science Prediction Universe (kurz SPU), geleitet und ins Leben gerufen von UniPat AI, hat dies aufmerksam bemerkt.
116 Aufgaben, 4.207 Nasslabor-Experimente, abdeckend Chemie, Materialwissenschaft, Biologie und Medizin. Die Benchmark-Berater und Nasslabor-Kollaborateure kommen außerdem von Universitäten wie Stanford, Cornell und Harvard sowie von Spitzenforschungseinrichtungen und Biotech-Unternehmen auf dem Gebiet.
Das Modell folgt jedes Mal einem 8-Stunden-Arbeitstag-System, ist mit einer H20 ausgestattet und entscheidet dann selbstständig, wie es Retrieval- und Rechenressourcen nutzt, um experimentelle Vorhersagen zu bilden.
Die Ergebnisse überraschten alle.
Selbst starke Modelle wie Opus 5.5 und GPT-6 Astra sind den Daten zufolge noch sehr weit davon entfernt, tatsächlich Vorhersagen leisten zu können...
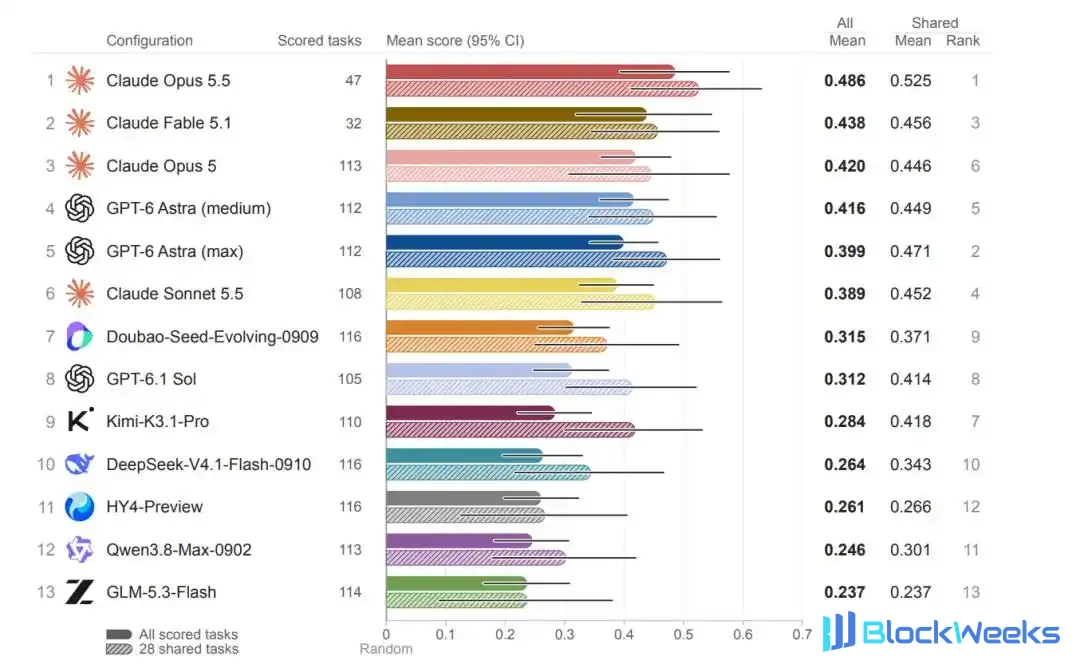
△Durchschnittliche Punktzahlen der einzelnen Konfigurationen über alle bewerteten Aufgaben
Ich muss sagen, SPU hat allen Forschungsmodellen ein hartes Gericht serviert.
Jene Forschungsfähigkeiten, die früher unsichtbar und unfassbar waren, sind nun zu numerischen Werten geworden, die einheitlich bewertet und kontinuierlich untersucht werden können.
Was die Frage betrifft, wie sich das wissenschaftliche Urteilsvermögen der KI Schritt für Schritt entwickelt, gibt es nun eine konkretere Grundlage für die Diskussion.
Nasslabor-Vorhersage: eine eigene Prüfung wert für Modelle
Zurück zur Nasslabor-Vorhersage – zunächst einmal ist dies tatsächlich keine neue Frage.
Es gab viele solcher Momente in der Wissenschaftsgeschichte: Vor dem Experiment wird ein Urteil gefällt, und dann wird es dem Prozess überlassen, zu entscheiden – wenn es richtig ist, bleibt es; wenn es falsch ist, wird es umgestoßen.
Die spezifische Logik des Urteilens bildet den Geschmack eines Wissenschaftlers.
Mit gut genug Geschmack und ausreichend genauer Intuition können Wissenschaftler schneller große Ergebnisse erzielen und dabei wertvolle experimentelle Ressourcen sparen.
Schließlich ist schon ein einziges Nasslabor-Experiment teuer – in der Chemie müssen Reagenzien vorbereitet, Reaktionsbedingungen eingestellt und anschließend die Produkte getrennt werden; in der Biologie muss man zudem eine langwierige Proteinexpression durchlaufen ... Der Zeitaufwand und die Kosten für die Werkzeuge sind an sich schon recht hoch, und wenn die Ergebnisse nicht ideal sind, muss man es immer wieder von vorn machen, über mehrere Runden hinweg.
Daher ist die Vorhersage vor dem Start der wertvollste Schritt im Forschungsprozess.

Der einzige Unterschied besteht darin, dass dies früher ausschließlich von Wissenschaftlern selbst erledigt wurde und nun im KI-Zeitalter auch Modelle diese Fähigkeit besitzen müssen und außerdem einen Testbogen benötigen, der sie bewerten kann.
Bestehende Benchmarks können dies noch nicht vollständig abdecken. Beispielsweise lässt BrainBench Modelle experimentelle Ergebnisse direkt beurteilen; ScienceAgentBench konzentriert sich darauf, Analysen auf vorhandenen Daten abzuschließen; und Benchmarks für langfristige Aufgaben wie Terminal-Bench 4.0 und Long-Horizon-TB verwenden hauptsächlich vorgegebene Tests, um Aufgabenausgaben zu überprüfen.
SPU unterscheidet sich von allen diesen.
Es legt mehr Wert darauf, den autonomen Forschungsprozess der KI zusammen mit der Vorhersage von Nasslabor-Ergebnissen zu testen, wobei sowohl die Vorhersageleistung als auch die Fähigkeit zur Nutzung wissenschaftlicher Werkzeuge und zur Ausführung langfristiger Aufgaben einbezogen werden.

△Die Grafik wurde von KI erstellt
Diese Art der Beurteilung wurde von SPU auch in klare Aufgaben gegliedert.
100 öffentliche Aufgaben wurden jeweils 85 kürzlich veröffentlichten Arbeiten entnommen. Fachexperten ordneten die Kandidatenoptionen, Materialien, Bedingungen und Messmethoden aus der Forschung und behielten vollständige quantitative Ergebnisse als Grundlage für die Bewertung bei.
Darüber hinaus stammen 16 private Aufgaben aus vier Gruppen unveröffentlichter kollaborativer Nasslabor-Experimente, die VHH-Nanobodies, Reaktionsbedingungen, Elektrolyte und Magrolimab-Varianten umfassen.
Insgesamt 32 Teilgebiete und 4.207 Experimente, wobei die öffentlichen Forschungsarbeiten interdisziplinäre Aufgabenquellen liefern, die gemessenen Ergebnisse vor den Modellen verborgen werden und die unveröffentlichten Experimente Tests unabhängig von den Antworten in öffentlichen Arbeiten hinzufügen.
In gewissem Maße kann dies verhindern, dass die Modelle die Fragen im Voraus gesehen haben.

△Aufgabenabdeckung und -quellen von SPU
Auch der Auswahlprozess der Fragen ist recht speziell.
Experten bevorzugen Studien mit vollständigen Messungen und klaren Bedingungen; einfache Fragen, die entlang eines einzigen Trends eingestuft werden können, werden direkt ausgeschlossen, und Fragen mit zu nahe beieinanderliegenden Werten gelten ebenfalls als wenig aussagekräftig.
Die letztlich verbleibenden Fragen sind alle schwieriger und unterscheidungskräftiger.
Während des konkreten Vorhersageprozesses muss das Modell jedes Mal acht Stunden lang laufen, ausgestattet mit einer 8-Kern-CPU, 16 GiB Arbeitsspeicher und einer H20, wobei es online suchen und wissenschaftliche Software installieren darf.
Während dieser Zeit sammelt das Modell selbstständig Belege, wählt Berechnungsmethoden und reicht schließlich für jede Vergleichsgruppe die vorhergesagte Rangfolge von niedrig nach hoch ein.
Um eine Kontamination des Gedächtnisses zu verhindern, wird der Bewertungsprozess zudem durchgängig in einem unabhängigen, offline betriebenen Container durchgeführt; der KI ist es untersagt, die ursprünglichen Forschungsergebnisse abzurufen, und die Ausgaben der Werkzeuge werden automatisch gescannt, um Identifikatoren wie die DOI und den Titel der Quellpublikation zu erkennen.
Schließlich verwendet das System den Spearman-Korrelationskoeffizienten, um die vorhergesagte Rangfolge mit der gemessenen Rangfolge zu vergleichen.
Je näher der Koeffizient an 1 liegt, desto näher liegt die Rangfolge an den experimentellen Ergebnissen.

△Der Bewertungsprozess von SPU
Interessanterweise legt SPU auch Wert auf viele Details, die bei Benchmark-Tests nicht berücksichtigt wurden.
Beispielsweise berücksichtigt SPU bei der Endpunktzahl, ob diese möglicherweise auf Glück zurückzuführen ist, falls es sich um einen Blindgänger handelte, der zufällig ins Schwarze traf.
Daher generiert es zusätzlich 4.000 zufällige Rangfolgen für jede Frage, verwendet das 95. Perzentil als Schwellenwert für das Zufallsniveau und prüft, ob die Einreichung des Modells diese Referenz signifikant übersteigt. Auch für unterschiedliche Aufgaben gibt es entsprechende Referenzgrundlagen.
Das Design des gesamten SPU kann als wissenschaftlich rigoros bezeichnet werden.
Das Modell muss darin Schritt für Schritt selbst beurteilen, was es wert ist, berechnet zu werden, und seine endgültige Vorhersage einreichen.
Dieses Design hilft nicht nur dabei, die aktuelle Nasslabor-Vorhersagefähigkeit der KI zu messen, sondern weist auch die Richtung für nachfolgende Forschungsteams, Experimente mit Hilfe einheitlicher Metriken kontinuierlich zu verbessern.
Das gesagt, wollen wir uns als Nächstes gemeinsam die Zeugnisse der ersten Charge von Frontier-Modellen ansehen. Die Details sind durchaus eine separate Erörterung wert.
Der neue Test lässt Frontier-Modelle kollektiv zusammenbrechen
Die erste systematische Bewertungsrunde von SPU umfasst 12 Frontier-Modelle und 13 Konfigurationen. Die Konfigurationen hier beziehen sich auf das Modell, die Inferenzintensität und das verwendete Modellframework.
Sprechen wir zunächst über die Gesamtergebnisse.
In einem Satz: Keines von ihnen ist gut.
Über alle bewerteten Aufgaben hinweg erzielte Claude Opus 5.5 die höchste Durchschnittspunktzahl mit 0,486 Punkten. Aber selbst bei ihm übertrafen nur die Hälfte der Aufgaben das Zufallsniveau.
Unter den 13 Konfigurationen ist dies fast immer der Fall; der Anteil der Aufgaben, die den Schwellenwert für das Zufallsniveau überschreiten, beträgt nur 34 % bis 52 %.
Mit anderen Worten: Alle vorgestellten Modelle haben noch einen weiten Weg vor sich, bevor sie eine wirklich zuverlässige Nasslabor-Vorhersage leisten können.

△Verhaltensvergleichsanalyse der Spitzengruppe und der Schlussgruppe
Es gibt jedoch auch Unterschiede zwischen den Modellen, und die durchschnittliche Leistung lässt sich in zwei Stufen einteilen:
die Spitzengruppe (6 Modelle) und die Schlussgruppe (7 Modelle).
Bei Vergleichen mit denselben Fragen liegt die Spitzengruppe im Durchschnitt immer noch etwa 0,15 Punkte höher als die anderen sieben.
Es gibt noch ein weiteres erwähnenswertes Detail. Etwa 9 % der Aufgaben in der Spitzengruppe erzielten weniger als 0 Punkte, während dieser Anteil bei den anderen sieben Konfigurationen bis zu 22 % betragen kann.
Hier bezieht sich 0 auf die Durchschnittspunktzahl einer zufälligen gültigen Rangfolge; eine negative Punktzahl bedeutet, dass die Vorhersage negativ mit der tatsächlichen Rangfolge korreliert ist.
Wo genau kommt die Lücke her? Das Forschungsteam hat einen Schritt tiefer gegraben.
Sie kombinierten zunächst die Vorhersagen anderer Modelle zur selben Frage zu einem Referenzranking, paarten dann die Experimente paarweise, verglichen sie mit den gemessenen Ergebnissen und prüften, ob jedes Modell sie einzeln korrekt einordnete.
Bei Experimentpaaren, bei denen das Referenzranking korrekt war, ordnete die führende Gruppe sie in 86% der Fälle korrekt ein, während die anderen sieben Konfigurationen 78% erreichten; bei Experimentpaaren, bei denen das Referenzranking falsch war, ordneten beide Gruppen sie unabhängig voneinander in etwa 30% der Fälle korrekt ein.
Tatsächlich spiegelt sich ein Teil des Vorteils der führenden Gruppe genau an den Stellen wider, an denen die Vorhersagen gemeinsam korrekt sind; in diesem Teil ist die führende Gruppe stets stabiler.

Was die Frage betrifft, warum das Modell von der korrekten Beurteilung abweicht, enthalten die Ausführungsprotokolle konkretere Hinweise.
Nehmen wir die Lösungsaufgabe als Beispiel. Für dieselbe Polymerisationsreaktion wurden nacheinander 12 Lösungsmittel verändert, und die Aufgabe erforderte eine Rangfolge nach der Masse des schließlich abgetrennten Polymers.
Opus 5.5 erzielte 0,874, während Qwen3.8 -0,126 erzielte. Die 12 Kandidaten-Lösungsmittelbedingungen wurden paarweise kombiniert, insgesamt 66 Paare; Ersteres ordnete 56 Paare korrekt ein, Letzteres 30 Paare korrekt.

△Zwei Läufe von Opus und Qwen zur selben Aufgabe
Die Analyse ergab, dass dies daran liegt, dass sich die beiden von Anfang an in den Faktoren unterschieden, auf die sie sich konzentrierten:
Qwen3.8 ordnete hauptsächlich danach ein, wie viel Ethylen das Lösungsmittel lösen kann, während Opus 5.5 mehr auf die Mischbarkeit der Rohstoffe und die Verträglichkeit des Katalysators im Lösungsmittel achtete.
Obwohl Qwen3.8 dieses Problem auch während des Berechnungsprozesses entdeckte, gelang es ihm letztlich nicht, die schließlich vom Modell angenommene Rankinggrundlage direkt zu ändern.
Daher ist die Phase, in der Vorhersagefehler am wahrscheinlichsten auftreten, der Schritt der Wahl der Beurteilungsgrundlage. Das Modell muss auch lernen, die Rankingmethode anhand der Hinweise in Echtzeit anzupassen, damit diese Erkenntnisse die Antwort tatsächlich beeinflussen können.
Aufgeschlüsselt variieren diese Unterschiede auch je nach Fachdisziplin und Aufgabe.
Unter den bewerteten Ergebnissen für jede Disziplin in den öffentlichen Aufgaben war die höchste Durchschnittspunktzahl in der Chemie Opus 5.5, in den Materialwissenschaften Fable 5.1, in der Biologie GPT-6 Astra Medium und in der Medizin Opus 5.
P.S. Fable 5.1 und Opus 5.5 zeigten ein Antwortverweigerungsverhalten.

△Punktzahlen der einzelnen Modelle über die vier Disziplinen
Wenn Sie also planen, KI an einer bestimmten Art von Forschung zu beteiligen, sollten Sie zunächst eine verwandte Aufgabe finden und sie mit SPU testen und erst mit formellen Experimenten fortfahren, nachdem Sie bestätigt haben, dass das Modell wirklich geeignet ist.
Die Ergebnisse privater Aufgaben machen diesen Punkt noch konkreter.
Von den 13 Konfigurationen hatten 12 Durchschnittspunktzahlen, die deutlich über dem Zufallsranking lagen, und es wurden keine offensichtlichen Unterschiede zwischen den Konfigurationen festgestellt. Im Gegensatz dazu war die Variation, die durch unterschiedliche Aufgaben entsteht, besonders auffällig.
Für dieselbe Charge von Elektrolyten lagen bei der Vorhersage der Ionenleitfähigkeit die Rangkorrelationskoeffizienten der 13 Konfigurationen konzentriert im Bereich von 0,89 bis 0,95; beim Wechsel zum elektrochemischen Fenster reichten die Bewertungen der 12 Konfigurationen, die Bewertungen erhielten, von -0,55 bis 0,07, keine überschritt die Zufallsniveau-Schwelle.
Das Modell änderte sich nicht, aber sobald sich das Messziel änderte, änderte sich auch die Bewertungsverteilung deutlich.
Wenn Sie also das nächste Mal ein Modell bewerten, reicht die Aussage, dass es gut in Chemie ist, nicht aus; Sie müssen auch sehen, welches konkrete Messziel und welche experimentellen Bedingungen es vor sich hat.

△Vorhersageleistung der einzelnen Modelle bei den 16 privaten Aufgaben
Hier ist noch etwas ziemlich Kontraintuitives:
Im Allgemeinen sollte dem Modell mehr Zeit und eine höhere Argumentationsintensität zu geben die Bewertung doch weiter steigen lassen, oder?
Alle denken im Allgemeinen so, und alle machen es so.
Aber raten Sie mal? Als die SPU-Ergebnisse herauskamen, haben sie uns direkt ins Gesicht geschlagen –
Unter denselben 8 Stunden Rechenzeit stellte das Forschungsteam GPT-6 Astra von mittlerer Argumentationsintensität auf die höchste Stufe. Die mediane Laufzeit bei der höchsten Intensität stieg auf das 4,8-Fache, und die medianen API-Kosten stiegen ebenfalls auf das 5,3-Fache.
Aber die Vorhersagebewertung ... bewegte sich kaum.
Hä? Das Forschungsteam ging sogar eigens zurück, um die Modelllaufprotokolle durchzusehen.
Und siehe da, bei den 79 abgeschlossenen Aufgaben hatte GPT-6 Astra mit der höchsten Argumentationsintensität üblicherweise bereits nach dem medianen 26 % des Laufs eine Antwort gegeben.
Das Modell war danach auch nicht untätig; es rechnete und überarbeitete weiter, aber das waren alles Feinjustierungen und zeigten sich nicht als Unterschiede in den Ergebnissen.
Mit anderen Worten: Eine höhere Argumentationsintensität macht die Ergebnisse nicht unbedingt besser.

△Investition und Leistung von GPT-6 Astra unter zwei Argumentationsintensitäten
Dieses Phänomen dient auch als Erinnerung für die Ressourcenzuweisung von Modellen: Wenn Sie Rechenleistung hinzufügen wollen, stürmen Sie nicht blind vor – es ist zeitaufwendig, arbeitsintensiv und zahlt sich möglicherweise nicht einmal aus.
Stattdessen können Sie die Laufprotokolle sorgfältiger prüfen, zuerst vollständig verstehen, welchem Urteil die neu hinzugefügten Belege tatsächlich entsprechen, und dann gezielt die Rechenleistung lokal verstärken.
Tatsächlich zeigt sich ein ähnliches Phänomen auch bei der Werkzeugnutzung.
In jedem Lauf beträgt die mediane Anzahl der von GPT-6 Astra Max verwendeten Methodenkategorien 4, während sie bei Medium 1 beträgt, dennoch wurde zwischen den beiden Konfigurationen kein signifikanter Unterschied in den Bewertungen festgestellt.
Der Grund ist weitgehend derselbe: Gute Werkzeuge wurden nicht dort eingesetzt, wo es am wichtigsten war.
Zum Beispiel bei der Monte-Carlo-Stichprobe: Obwohl das Modell dieses Werkzeug die meiste Zeit aufruft, fügt es dem endgültigen Ranking nur eine Fehlermarge hinzu und beeinflusst das Ergebnis selbst nicht direkt.

△Aufruf wissenschaftlicher Rechenwerkzeuge
Tatsächlich ist es also nicht besser, Werkzeuge häufiger zu verwenden, sondern sie präzise zu verwenden.
GPU-Nutzung bietet ebenfalls eine interessante Perspektive.
Selbst wenn ausreichend GPU-Rechenleistung bereitgestellt wird, waren tatsächlich nur 255 Läufe bei der GPU-Berechnung erfolgreich, weniger als ein Fünftel.
Verschiedene Modelle und verschiedene Disziplinen unterscheiden sich in ihren GPU-Läufen, sodass allein die Betrachtung der Anzahl der GPU-Aufrufe kaum die Forschungsfähigkeit eines Modells anzeigen kann.
Um zu beurteilen, ob die Rechenleistung geholfen hat, muss man immer noch sehen, wofür gerechnet wurde, ob die Berechnungsergebnisse bei der Vorhersage geholfen haben und wie diese Ergebnisse das endgültige Ranking beeinflusst haben.
Der Schlüssel liegt weiterhin darin, die Rechenleistung auf die für das Ranking relevanten physikalischen Größen zu richten, damit das Modell Vorhersagen präziser abschließen kann.

△GPU-Nutzungsstatistik
Betrachtet man die Kosten gemeinsam, reichen die durchschnittlichen API-Kosten pro Lauf über die Konfigurationen hinweg von 0,22 $ bis 65,91 $, eine Lücke von ganzen 300 Mal.
Das bedeutet, dass SPU sowohl Vorhersageleistung als auch Aufrufkosten bietet, eine gute Referenz für Teams, die Forschungsmodelle bereitstellen wollen.
Von Gesamtbewertungen zu Verläufen pro Frage entfaltet SPU die Unterschiede zwischen Modellen bis in jedes Detail wissenschaftlicher Urteilsbildung, etwa Rechenleistung und Kosten.
Wie sehr die von der KI berechneten Werte tatsächlich bei der Vorhersage helfen; wenn eine Vorhersage schiefgeht, welche Urteile überprüft werden sollten ... all das kann durch die Kombination von Versuchsergebnissen mit Laufprotokollen weiter analysiert werden.
Die nächste Verbesserungsrunde hat damit eine klare Richtung zum Ausprobieren:
Laut SPU kann das Modell fehlerhafte Hypothesen schneller erkennen und Rankings mit besserer Begründung beibehalten oder ändern. Nach den Änderungen setzt man es wieder in dieselbe Aufgabe ein, um zu sehen, ob die Vorhersagen genauer werden.
Das „Testverständnis“ in den Prüfungsraum des Modells bringen
Man kann sagen, dass SPU stark mit den Entwicklungsmustern von AI4S übereinstimmt.
Die AI4S-Evaluierung dringt allmählich in reale Versuchsphasen vor, und auch in diesem Jahr sind Benchmarks entstanden, die auf die Versuchsdurchführung ausgerichtet sind.
Doch jenseits der Durchführung hat die Vorhersage als unvermeidbarer Schritt im Forschungsprozess und als der am schwersten zu quantifizierende endlich eine messbare Methode.
Der Nutzen zeigt sich in zwei Aspekten:
Forschende können dadurch analysieren, welche Messziele leichter vorherzusagen sind, welche Aufgaben sich am stärksten unterscheiden und wie ein fehlerhaftes Urteil entsteht. Dies kann teure und wertvolle Versuchsressourcen sparen und die Entscheidungszeit verkürzen.
Für die Modellentwicklung bietet dies ebenfalls eine konkretere Referenz für Verbesserungen.
Mit zunehmenden Versuchsarten kann die Evaluierung auch spezifischere Fragen beantworten: Für welche Materialien, Versuchsbedingungen und Messmethoden sind die von der KI gegebenen Rankings zuverlässiger und eher als Referenz geeignet.
Wissenschaftler können so rund um dieselbe Art von Fragen kontinuierlich Fortschritte ansammeln.

Tatsächlich ist SPU nur die Spitze des Eisbergs in der UniPat-AI-Reihe von Bewertungen realer Arbeit:
- ScienceVision: konzentriert sich darauf, wie Modelle Belege aus dreidimensionalen wissenschaftlichen Objekten gewinnen und Fragen beantworten;
- PaperBenchX: verwandelt veröffentlichte Forschung in ausführbare, verifizierbare Aufgaben zur Reproduktion von Papern;
- SaaS-Bench und EvoCode-Bench: untersuchen jeweils tatsächliche Softwareprozesse und Entwicklungsarbeit, wenn sich Anforderungen kontinuierlich ändern. ...
Diese Arbeiten decken wissenschaftliche Forschung, Büroarbeit und Softwareentwicklung ab und teilen alle ein Interesse daran, wie KI Aufgaben abschließt, nachdem sie in eine bestimmte Arbeitsumgebung eingetreten ist, und wie Ergebnisse verifiziert werden.
Dies spiegelt auch indirekt wider, dass UniPat AI einzigartige Brancheneinblicke und vorausschauendes Urteilsvermögen in Bezug auf die Bewegung der KI hin zur wissenschaftlichen Forschungspraxis und sogar zur realen Welt besitzt.
UniPat AI demonstriert zudem eine neue Art von KI-Kollaborationsmodell:
Fachbereichsexperten beteiligen sich an der Aufgabenauswahl und -prüfung, Partnerlabore stellen unveröffentlichte Aufgaben bereit, und das Projektteam organisiert Experimente aus verschiedenen Disziplinen zu einheitlichen Bewertungsaufgaben.
Am Beispiel von SPU: Es wird von UniPat AI geleitet, und die Institutionen der Beratungsmitglieder umfassen Stanford, Cornell, Harvard, UIC, die Peking-Universität, HKUST und FutureHouse. Nasslabor-Kollaborateure von Yourui Saishi, Aibotaike, Deep Principle und Enhe Biology beteiligten sich an den zugehörigen experimentellen Arbeiten.
Interdisziplinäres Wissen und experimentelle Ressourcen gelangen so in denselben Bewertungsprozess. SPU trägt nicht nur die Auswahl der Probleme, sondern stellt auch die Zusammenarbeit dar, die erforderlich ist, um wissenschaftliche Forschungsprobleme in ausführbare Aufgaben zu organisieren.
Derzeit ist geplant, die 100 öffentlichen Aufgaben im Zusammenhang mit SPU als vollständige Harbor-Aufgabenpakete zu veröffentlichen; die 16 privaten Aufgaben bleiben privat für kontrollierte Bewertungen. Sowohl der Datensatz als auch der Code wurden als Open Source veröffentlicht.
Zugegebenermaßen ist die heutige KI angesichts dieses SPU-Mechanismus immer noch nur ein Neuling.
Sie kann Werkzeuge mit Blitzgeschwindigkeit nutzen und innerhalb von 8 Stunden drei Softwarepakete installieren, DFT fertig ausführen und dann Monte Carlo laufen lassen, doch bei der entscheidendsten Beurteilung hat sie noch nicht gelernt, sich selbst eine Frage zu stellen: Ist die Größe, die ich berechne, genau die Größe, die das Experiment tatsächlich messen muss.
Doch während solche Aufgaben weiter anwachsen, wird auch klar werden, welche Art wissenschaftlicher Forschungsarbeit KI übernehmen kann.
SPU hat diese Distanz gemessen, und jede weitere Prüfung ist ein Beleg dafür, dass sich die KI der realen Experimentierbank nähert.
Dieser Artikel stammt aus dem WeChat-öffentlichen Konto „Quantum位“ (ID: QbitAI), Autor: Fokus auf Spitzentechnologie